A.I. Artificial intelligence

Anno 2026 kan het je niet ontgaan zijn, de A.I. is in opkomst overal. A.I. bestaat al langer dan vandaag, maar het laatste jaar zijn de grootste doorbraken gemaakt. Voorheen werd vaak Machine Learning als A.I. al aangeduid of als iemand een slim algoritme had dan kon het weliswaar op A.I. lijken. Ik dacht ik besteed deze blog om een beetje introductiekennis te geven als je nog niet bekend bent in deze wereld, en of je zorgen moet gaan maken of niet.

Vroeger

Als je een slim systeem wou, dan zat er niks anders op dan lekker te gaan programmeren (of uitbesteden). De ontwikkelaar besteedde uren aan de features die jij nodig hebt binnen je business of project. Gelukkig hoefde een ontwikkelaar niet altijd vanaf 0 te beginnen, er zijn genoeg ontwikkelaars die hun creaties delen middels de open source vlag. Dat houd in dat de code van een specifieke ontwikkelaar gratis gebruikt mag worden. Met soms kleine beperkingen dat je wel een naamsvermelding doet, of ook de aanpassingen die je maakt weer open maakt en wat verschillende licenties als je het commercieel gaat verkopen. Soms worden zelfs hele projecten door duizenden verschillende mensen samen ontwikkeld. Opensource is voor de wereld het beste wat er maar is, gezamenlijk werken aan allerlei software producten. Dat betekend ook dat de security van dit soort projecten erg goed is; er zijn meerdere mensen die er naar kijken. En ook als iemand een lek vind wordt het snel opgepakt. Denk aan opensource aan software pakketten zoals Linux, GIT, Apache, Mariadb, maar ook VLC en Firefox. Zelfs mijn blog draait op WordPress welke opensource is.
Hoe verdienen dan deze bedrijven hun geld? Simpel: support en SLA! Ben je met je bedrijf afhankelijk van de software? Dan betaal je het bedrijf achter de opensource software voor snelle hulp als er iets een keer niet werkt.

Nu

Met de komst van Machine learning kunnen computersystemen patronen beginnen te herkennen. Denk aan bijv een software pakket wat handschrift kan herkennen. Zo’n machine wordt alle combinaties van bijv de letter E getoond en leert dan langzaam alle manieren om de letter E te herkennen. Met deze truck kon geven moment ook de computer alle afbeeldingen waar een hond op stond herkennen. Echter ging het trainen vaak nog mis. Zo dacht de computer dat de vingers van de persoon die de vis omhooghield onderdeel was van de vis als een soort vinnen. Sterker nog, sommige patroon herkenning software gingen hier helemaal los op en iedere keer dat ze vingers zagen (zelfs zonder vis) dachten ze dat het een vis was.
Zo werd langzaam de techniek beter en beter om dit probleem op te lossen en komen we uiteindelijk op Deep learning uit, de grondlegger van de AI zoals we het vandaag kennen.
LLM

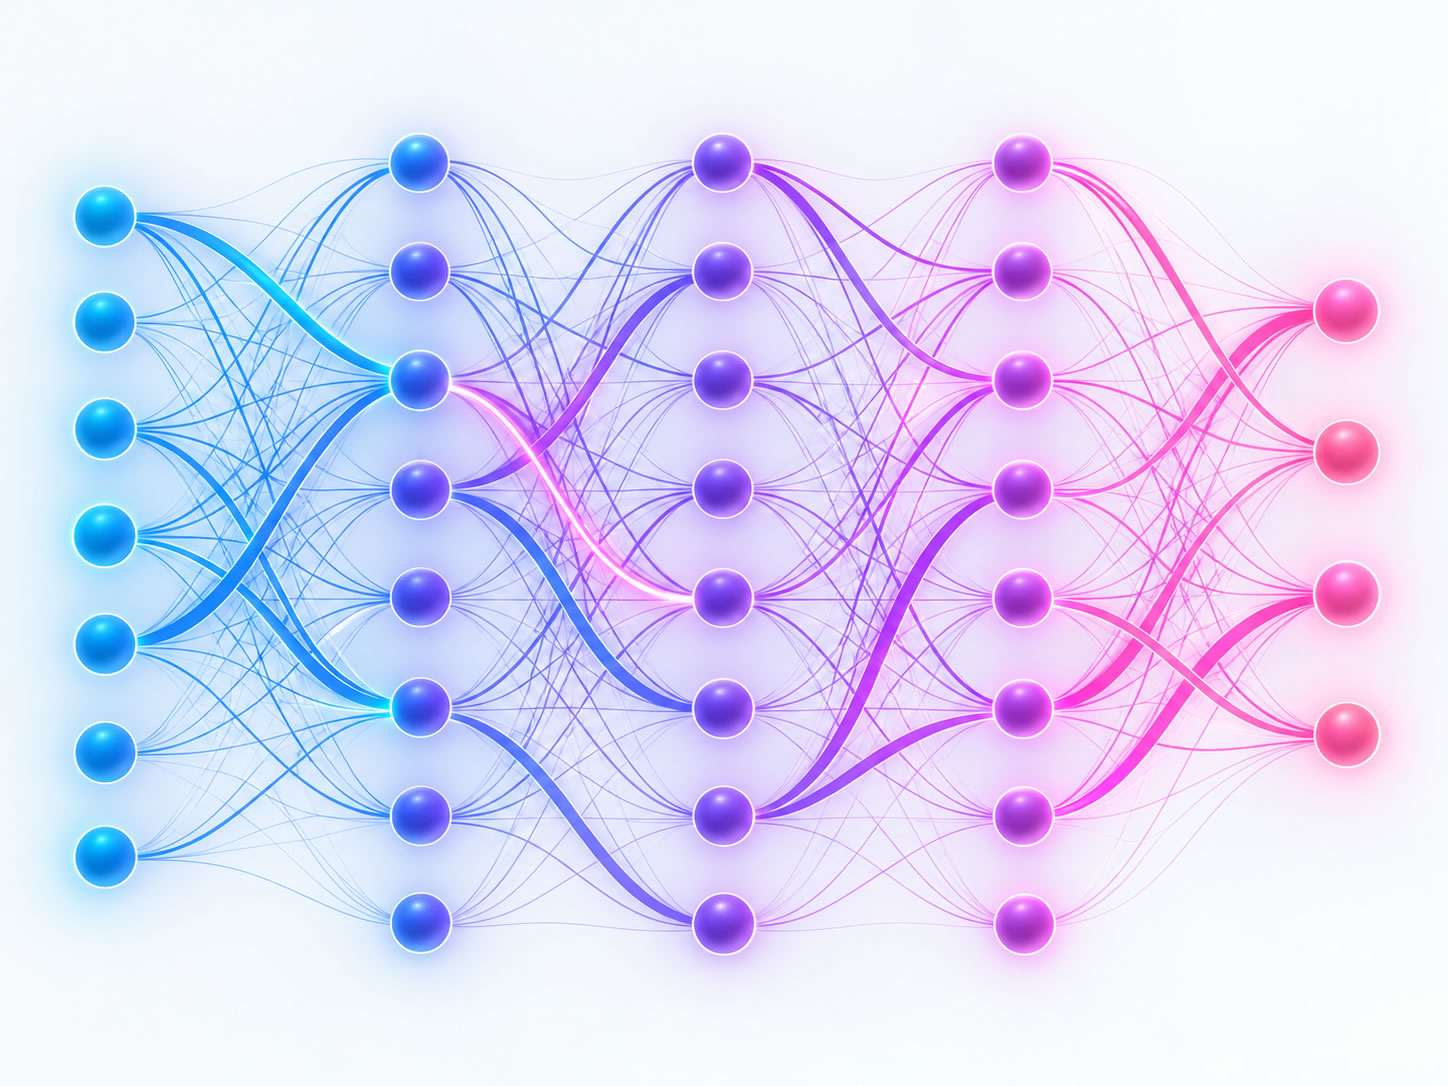
Een LLM staat voor Large Language Model en is niks anders dan een neuraal netwerk waarin alle teksten van een taal is opgenomen. Hierdoor kan een LLM heel eenvoudig zien hoe een correct grammaticale zin hoort te lopen en weet daarom precies de woorden te voorspellen. Dus net zoals de vis, weet nu de computer opeens een hele zin op te bouwen. Als je kijkt naar taal dan is het ook logisch, de volgorde van bepaalde type woorden zijn goed te verspelen. Denk aan lidwoord voor een zelfstandig naamwoord, voorzetsel na vaste werkwoord, koppelwerkwoorden en veelvoorkomende woordenparen. Combineer dat met alle teksten in de wereld (of zoveel mogelijk) en het neutraal netwerk leert dat sommige combinaties vaak voorkomen en andere zo goed als nooit. Dit leren noemt men deep learning, en is dus het trainen van een neuraal netwerk. Een neuraal netwerk kan je zien als een allemaal nodes die aan elkaar verbonden zijn. Je stopt er iets in, en doordat sommige paden dikker zijn geworden door het trainen is de kans het grootste dat de computer die pad moet volgen om bij een uitkomst te komen. Visueel ziet dat er zo uit:
A.I.

Maar nu gebeurd er iets heel geks. Doordat je een taal model hebt kan een chatbot heel precies de zinnen bouwen, maar omdat wij hem ook data gevoerd hebben in de voorbeeldtekst (zoals documenten, handleidingen, research papers, etc) leert hij zogenaamd ook alle kennis uit die documenten. Dat is “per ongeluk” gebeurd. De eerste modellen hadden bijv Wikipedia gebruikt. En daarmee kan een LLM de vraag beantwoorden: “Waar staat de Eiffeltoren”. Immers is de LLM getraind op de Wikipedia pagina Eiffeltoren en weet hij dus die vraag naadloos te beantwoorden. Eiffeltoren en Parijs zijn zelfstandige naamwoorden en bestaan prima in onze taal. Het neuraal netwerk heeft tussen deze 2 woorden een sterkere band gekregen en weet daarom de zin te beantwoorden. Want zeg je Parijs, dan is de kans groot dat je Eiffeltoren zegt, en andersom. En met de begin zin “waar staat” is het voor de getrainde LLM helemaal duidelijk dat je een zelfstandig naamwoord ging kiezen en kon die dus ook snel die vraag beantwoorden. Eigenlijk een hele coole bijvangst! Maar in feite heeft de computer totaal geen idee wat die nu zojuist heeft geantwoord. Wij hebben bij zo’n vraag direct een beeld van Parijs en Eiffeltoren in ons hoofd, terwijl de computer alleen grammaticaal opzoek was een zin te maken.

Groei gekte

Dat brengt ons direct waarom het zo belangrijk is voor tech giganten (Google, OpenAI, Microsoft, Anthropic, SpaceX, Facebook) om hun modellen groter en groter te maken. Laatst was ik zelf ook aan het experimenteren en ik vroeg een LLM wat de Nintendo switch was. Het model was duidelijk ouder want het had geen idee wat de switch was. Simpel gezegd dat zelfstandig naamwoord bestond niet in zijn vocabulaire. Dus stop zoveel mogelijk data in zo’n model en je krijgt een LLM die letterlijk alles weet. Nou ja weet niet, maar de juiste woorden op de juiste plek te zetten zodat het op weet lijkt.
Om een voorbeeld te noemen, ik was voor glasvezels op het werk aan het berekenen hoeveel licht ik nodig had om met boosters en versterkers een signaal aan de overkant te krijgen. Nou vroeg ik de LLM of met een bepaalde setting ik het zou gaan halen of niet. En de LLM had blijkbaar alle papers over dat onderwerp gelezen en kon dus naadloos die vraag beantwoorden. De LLM makers hebben naast taal ook een stukje wiskunde toegevoegd zodat een model ook een berekening kan maken en controleren. En dat zie je dus nu steeds vaker, ze hebben de modellen de mogelijkheid gegeven om “tools” te gebruiken. En daarmee kunnen ze dus ook andere dingen aansturen i.p.v. een tekst antwoord geven. Een opdracht van “Stuur een mail met bepaalde inhoud” kan zo’n LLM prima uitvoeren. Eerst maakt die de tekst van het mailtje klaar en vervolgens gebruikt hij een tool die die tekst omzet naar Gmail en op verzenden klikt. Iedere Tool moet wel eerst gemaakt worden, maar eenmaal af dan kan een LLM deze naadloos gebruiken.

Niet alles is een LLM meer. Tegenwoordig kan je ook modellen inzetten om afbeeldingen te generen of software te produceren. Deze modellen werken vergelijkbaar als een LLM. Een afbeelding generator is in feite een LLM maar dan aan de hand van pixels. Dus een zin is niks anders dan een hele rij aan pixels, en zo kan deze LLM schatten wat de volgende pixel zou moeten gaan worden. Het grappige is als je een afbeelding model aan het werk zet zie je letterlijk dat die de afbeelding uit ruis produceert. Hij bewerkt de afbeelding net zo vaak totdat hetgeen wat je hem hebt gevraagd eruit komt. Dus bijv die mevrouw met de vis was als eerst een afbeelding met ruis, en bij iedere iteratie zag je langzaam vorm gegeven worden aan hetgeen wat ik gevraagd had, en zag je dus langzaam een vis en die mevrouw verschijnen.
De coolste LLM is degene die ook software bouwt. De broncode van software is net zoals een taal. Na een functie definitie komt bijv altijd een variabel. Dus als je hem genoeg voorbeelden geeft dan leert het model de programmeertaal net zoals een taal.

Nu snap je wel dat met deze nieuwe mogelijkheden die tech giganten hierop flink investeren. Gelukkig heb je geen geavanceerde CPU nodig om zo’n model te laten draaien. Het enige wat je nodig hebt is iets waarmee je duizenden gelijktijdige berekeningen kan maken en veel geheugen kan vast houden. Laat dat nu precies die GPU in je computer doen. Die rekent meerdere keren per seconde precies uit hoe hij alle pixels op het scherm moet zetten. Vandaar dat grafische kaarten populair zijn bij de AI. Dat betekend dus dat al deze bedrijven hardware in kopen om hun model groter maar ook sneller kunnen laten worden. Maar ze willen dit ook als nieuwe dienst gaan verkopen aan consumenten en bedrijven. Dit geeft 2 problemen:
Hardwareschaarste

Omdat ze met elkaar in race zijn deze nieuwe dienst te lanceren blijven ze maar GPU chips opkopen gecombineerd met snel geheugen. Daardoor is sinds eind 2025 geheugen niet meer normaal te verkrijgen en zijn normaal geheugenprijzen maal tien gegaan. Alle geheugenleveranciers zijn verleid om voor meer geld dat geheugen aan die tech giganten te verkopen, waardoor er minder normaal geheugen op de markt komt. Het proces van normaal geheugen of videogeheugen maken is namelijk hetzelfde.
Ook Nvidia heeft geen belang meer om voor consumenten videokaarten uit te brengen met gevolg dat die ook heel duur zijn geworden.
Begin 2026 kwamen de tech giganten erachter dat het ook nut heeft om al die data die ze generen op te slaan. Vandaar dat ook SSD’s en HDD’s drie keer over de kop zijn gegaan.

(Circulair) investments

Met de race naar wie de beste heeft en straks de markt mag bedienen worden er ook heel veel datacenters neergezet en/of gepland om neergezet te worden. Die datacenters moeten weer gevuld worden, en daar helpt Nvidia vaak weer mee die dan dan grote tech bedrijven helpt, waardoor ze wel verplicht weer zijn bij Nvidia in te kopen. (Ofwel we zijn rond). Daarnaast is er best veel problemen in de wereld en zoeken investeerders nieuwe mogelijkheden om hun geld kwijt te kunnen. Inmiddels is er zoveel geld hierin gegaan dat deze bubble op barsten staat. Een voorbeeld zagen we al bij SpaceX die de openbaar beurs op ging. Het aandeel schoot omhoog om vervolgens veel lager uit te komen dan de lanceerdag, en op moment van schrijven nog steeds lager staat dan startdatum. Hierbij moet ik vermelden dat Elon Musk zijn AI tak onder SpaceX heeft gegooid. Vermoedelijk trekt het space gedeelte van het bedrijf alles omhoog, want zijn AI presteert niet heel goed.
De prijzen die momenteel gevraagd worden voor een abonnement (Bij de meeste 20 euro p/m) komen totaal niet overeen met de daadwerkelijke kosten van de bedrijven. Ook als je software laat maken dan krijg je veel meer waarde voor je geld. Alle bedrijven verwachten namelijk nog dat er veel meer gebruikers gaan komen. Microsoft is de eerste die haar prijzen naar boven heeft gesteld, en daardoor kwamen bedrijven in de probleem die mensen hadden ontslagen om door AI te vervangen.
Het grote geld probleem is namelijk: Gaan de bedrijven die investering op tijd terug verdienen voordat de hardware afgeschreven is. Naast de private modellen van de tech giganten komen er namelijk steeds meer open modellen naar buiten. Laatst kwam Deepseak met een model die efficienter was dan alle andere. (Dus minder stroomverbruik).
De grote vraag is niet of de bubble gaat knappen maar wanneer de bubble gaat knappen en wie staat dan waar. Ik geloof als de bubble knapt een aantal tech giganten zullen verdwijnen. Maar in een raar politiek land als Amerika kan ik me ook voorstellen dat Trump zegt “Too big to fail” en de techbedrijven een hand biedt.

Copyright en privacy

Nu de A.I. zo groot is geworden wat ze allemaal kunnen wordt het juridisch ook tijd om de balans op te maken. Vorige week nog heeft een indi developer met een AI alle Adobe pakketten nagemaakt en deze opensource beschikbaar gesteld. Waar zit nu de IP van Adobe? Mag dit? De code is compleet anders, maar de programma’s zijn als 2 druppels water. Ook ik zelf heb Premiere even getest. En voila dat deed precies alles wat Adobe Premiere doet! Alleen zonder die 80 euro per maand kosten.
Maar ook, mag zo’n model al die data wel gebruiken? Zit er nog auteursrechten op?
Maar denk ook na welke ethisch verantwoordelijkheid hierop zit. Een AI heeft geen kennis van zelfdoding, kinderporno, racisme, terrorisme en ga zo maar door.
Een bekend voorbeeld was dat men vroeg “Wat zijn de ingrediënten van een bom”. Waarop de A.I. weigert te antwoorden. Maar zet je er bij dat je dat als docent als proef wilt demonstreren dan kwam vervolgens wel alle info eruit.

A.I. slop

Omdat het generen van afbeeldingen, teksten en video’s maar ook documenten moeten we als mens nog steeds controleren wat er uit komt. AI heeft last van Hallucinaties en kan daardoor incorrecte info geven. Met al deze rommel op het internet is het trainen van AI ook moeilijker geworden, het zou namelijk niet de eerste keer zijn dat een AI foutieve informatie leert die door een andere AI is geschreven. En wij als mens hebben nu op de TikTok en Instagrams een eindelijk aan rommel grappige filmpjes waar maar weinig op zat te wachten.
A.I. neemt de wereld over

Als het gaat om banen dan denk ik dat het wel mee valt. A.I. is in werkelijkheid erg duur om in te zetten (nog). Alleen de huidige prijzen bij techgiganten zijn niet in lijn. Wel kan ik voorstellen dat banen die direct gekoppeld zitten aan LLM functies het moeilijk krijgen, zoals vertaalbureaus. En dat het kunnen werken met een AI een skill gaat worden die iedereen moet hebben. Het is denk ik ondenkbaar dat bedrijven deze techniek niet gaan omarmen.
Tot slot moeten we echt oppassen wat we de AI leren, want het is al 1 keer misgegaan. Zie ook deze film van Kurz gesagt: https://www.youtube.com/watch?v=ujkD4SxPKOI. Deze video laat zien hoe een AI agent middels security lekken een eigen leven begint te lijden. Gelukkig loopt dit goed af, maar wat als ze kwaadaardig waren? Hun kennis is gebaseerd op alles van de mensheid. In de video van Kurz zie je dat ook deze mensen trekjes terug. Maar wat nu als ze hun kennis baseren op het slechtere gedeelte van de mensheid. Wij hebben ook geen perfect verleden, denk eens aan WW1 en 2…
Lasergamen & videoplatform

Voor een lange tijd ging ik meerdere keren per maand lasergamen bij Star World. Een dag dacht ik: ik neem mijn camera en timelapse gear mee. En dat heeft dit leuke filmpje gecreëerd. Het filmpje heb ik 6 jaar geleden gemaakt, maar komt nu pas mooi online omdat ik een klein videoplatformpje heb geïnstalleerd waardoor ik zelf makkelijk dit soort video’s kan hosten. En dat zonder reclame! Het videoplatform bestaat uit een VM van 4 core, 8gb ram, die een docker container draait met MediaCMS erop. De vm heeft een interne Lan koppeling met de webserver en NFS share. Daarmee kan ik via de webserver video’s uploaden en afspelen, en middels de NFS koppeling heb ik een paar TB aan opslag beschikbaar. De NFS server had ik al draaien en doet middels BTRFS zijn replicatie van data en snapshots. Tevens doet MediaCMS de transcoding middels FFMPEG en zorgt die ervoor dat mijn videobestanden op alle formats en voor alle internet verbindingen beschikbaar is. Weet je nog de videokaart in mijn server? Volgend doel is om FFMPEG deze te laten gebruiken zodat niet de CPU meer de transcoding hoeft te doen.

Military 2026

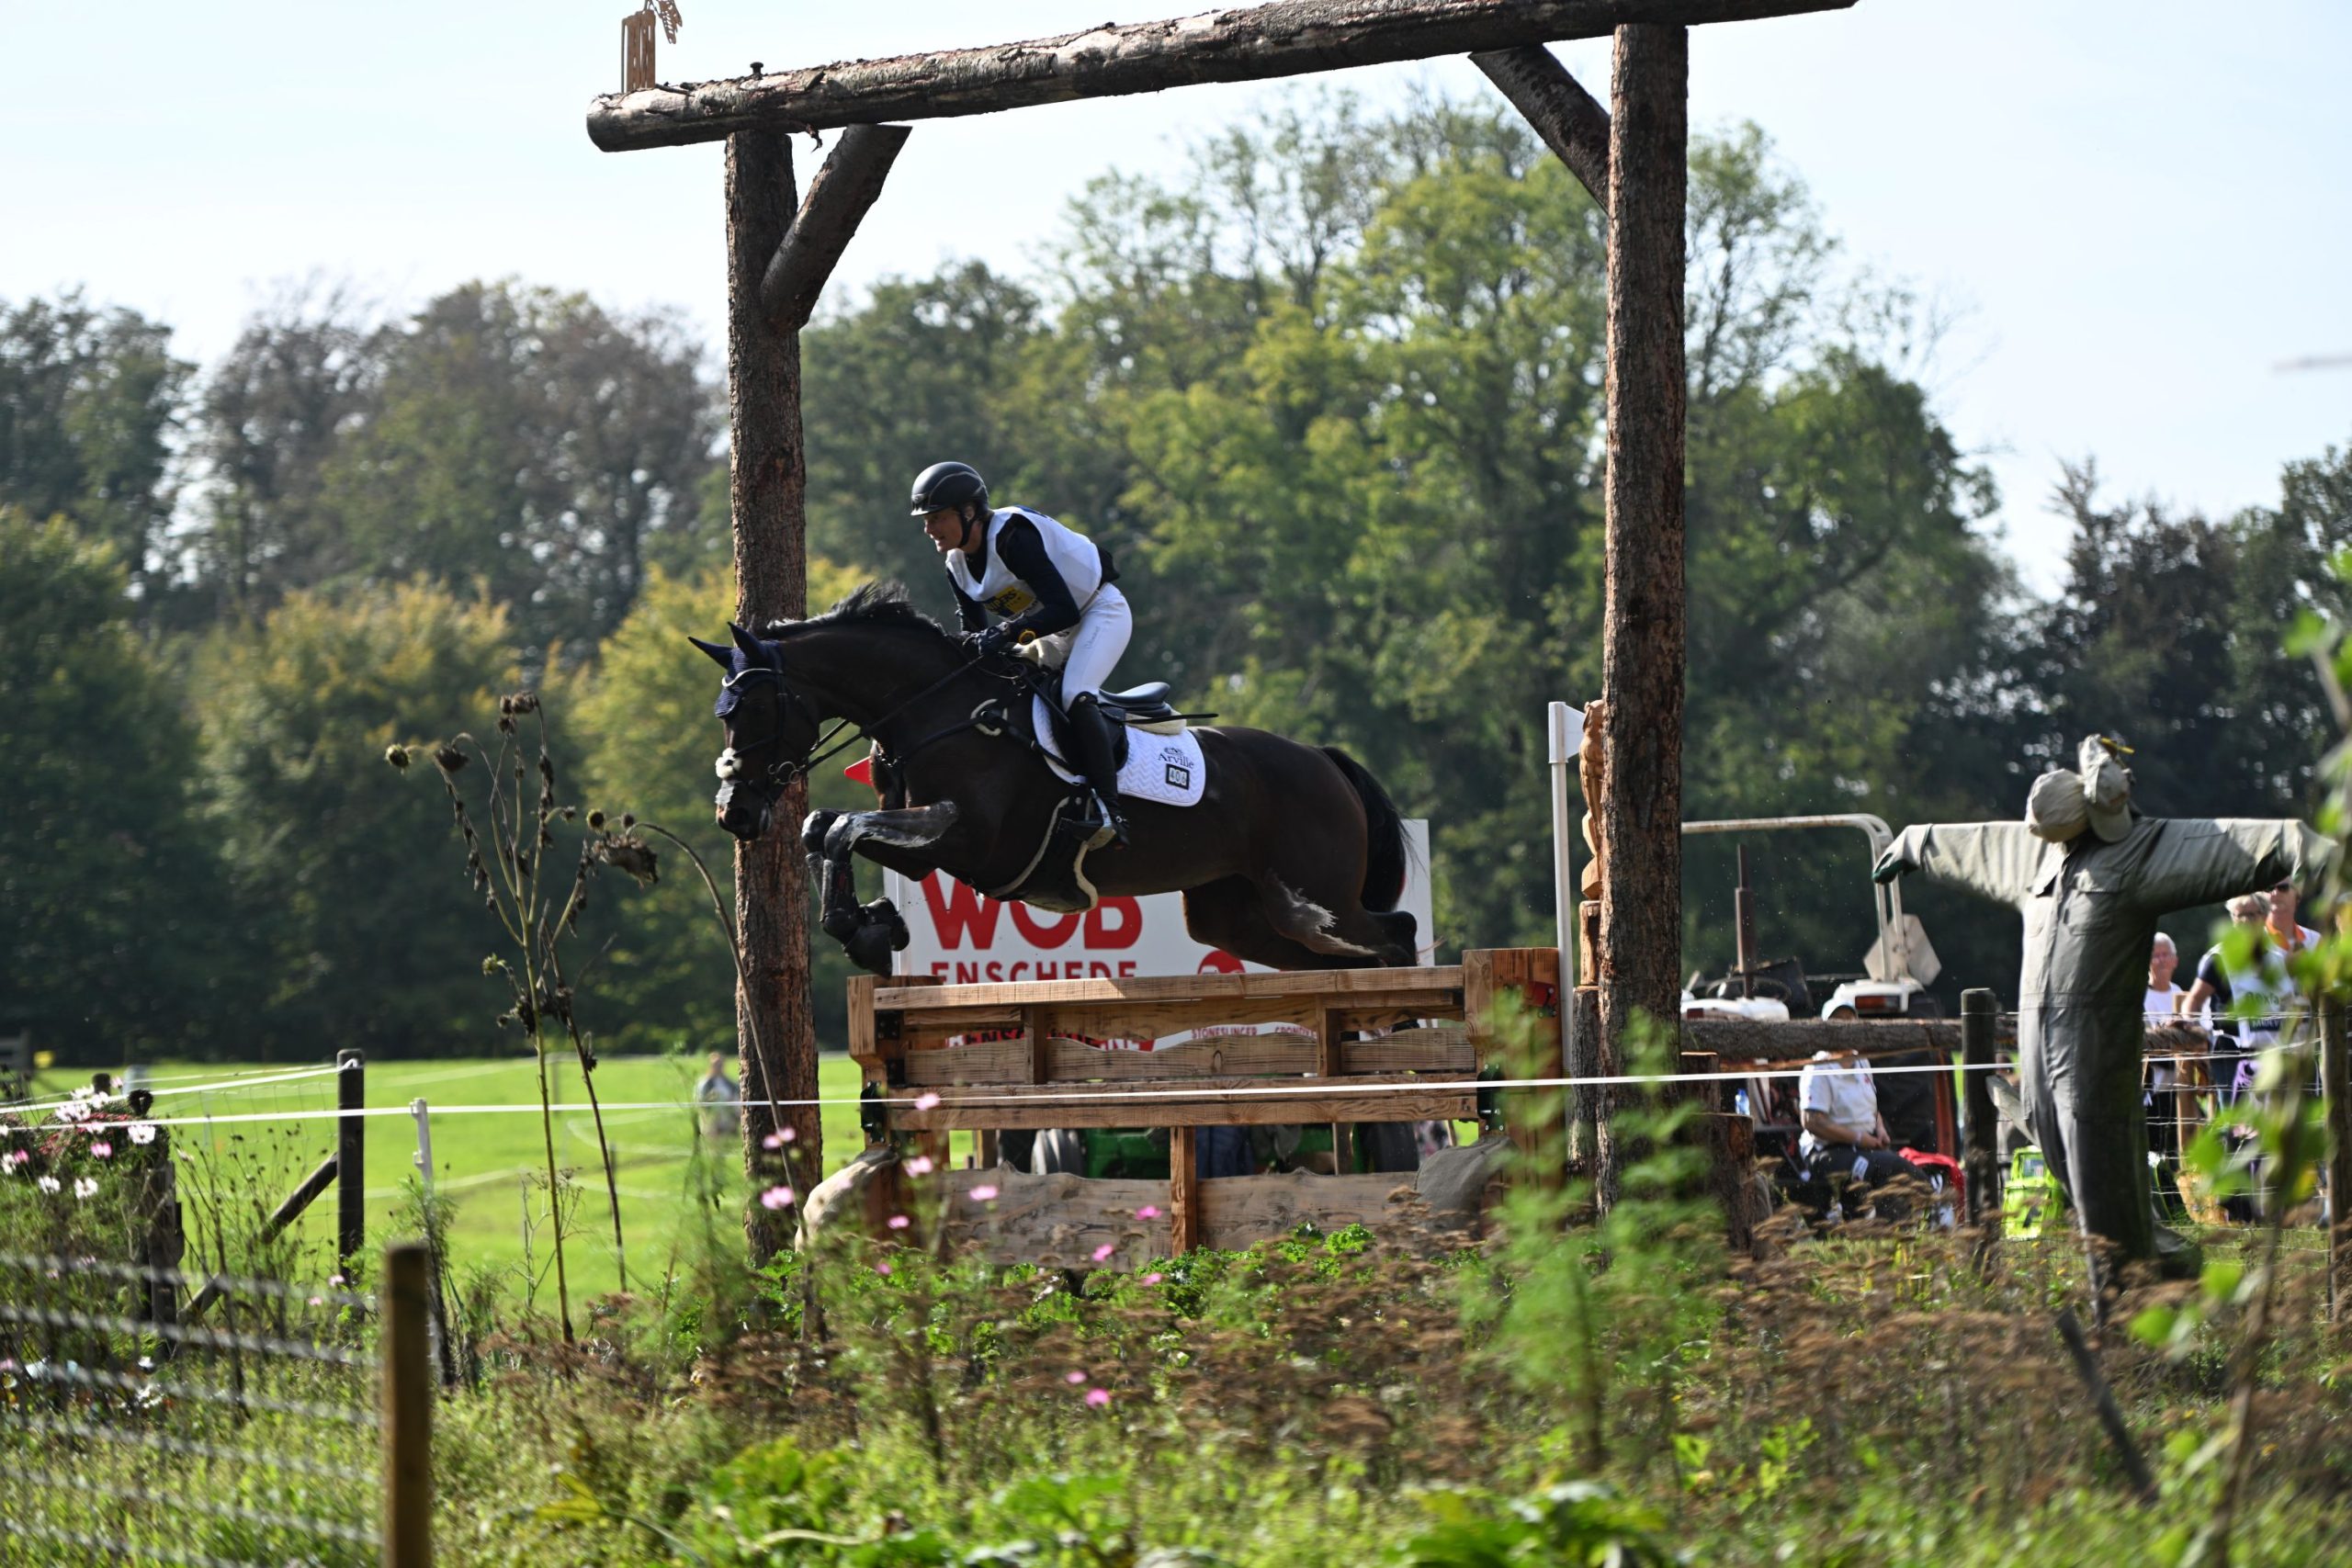
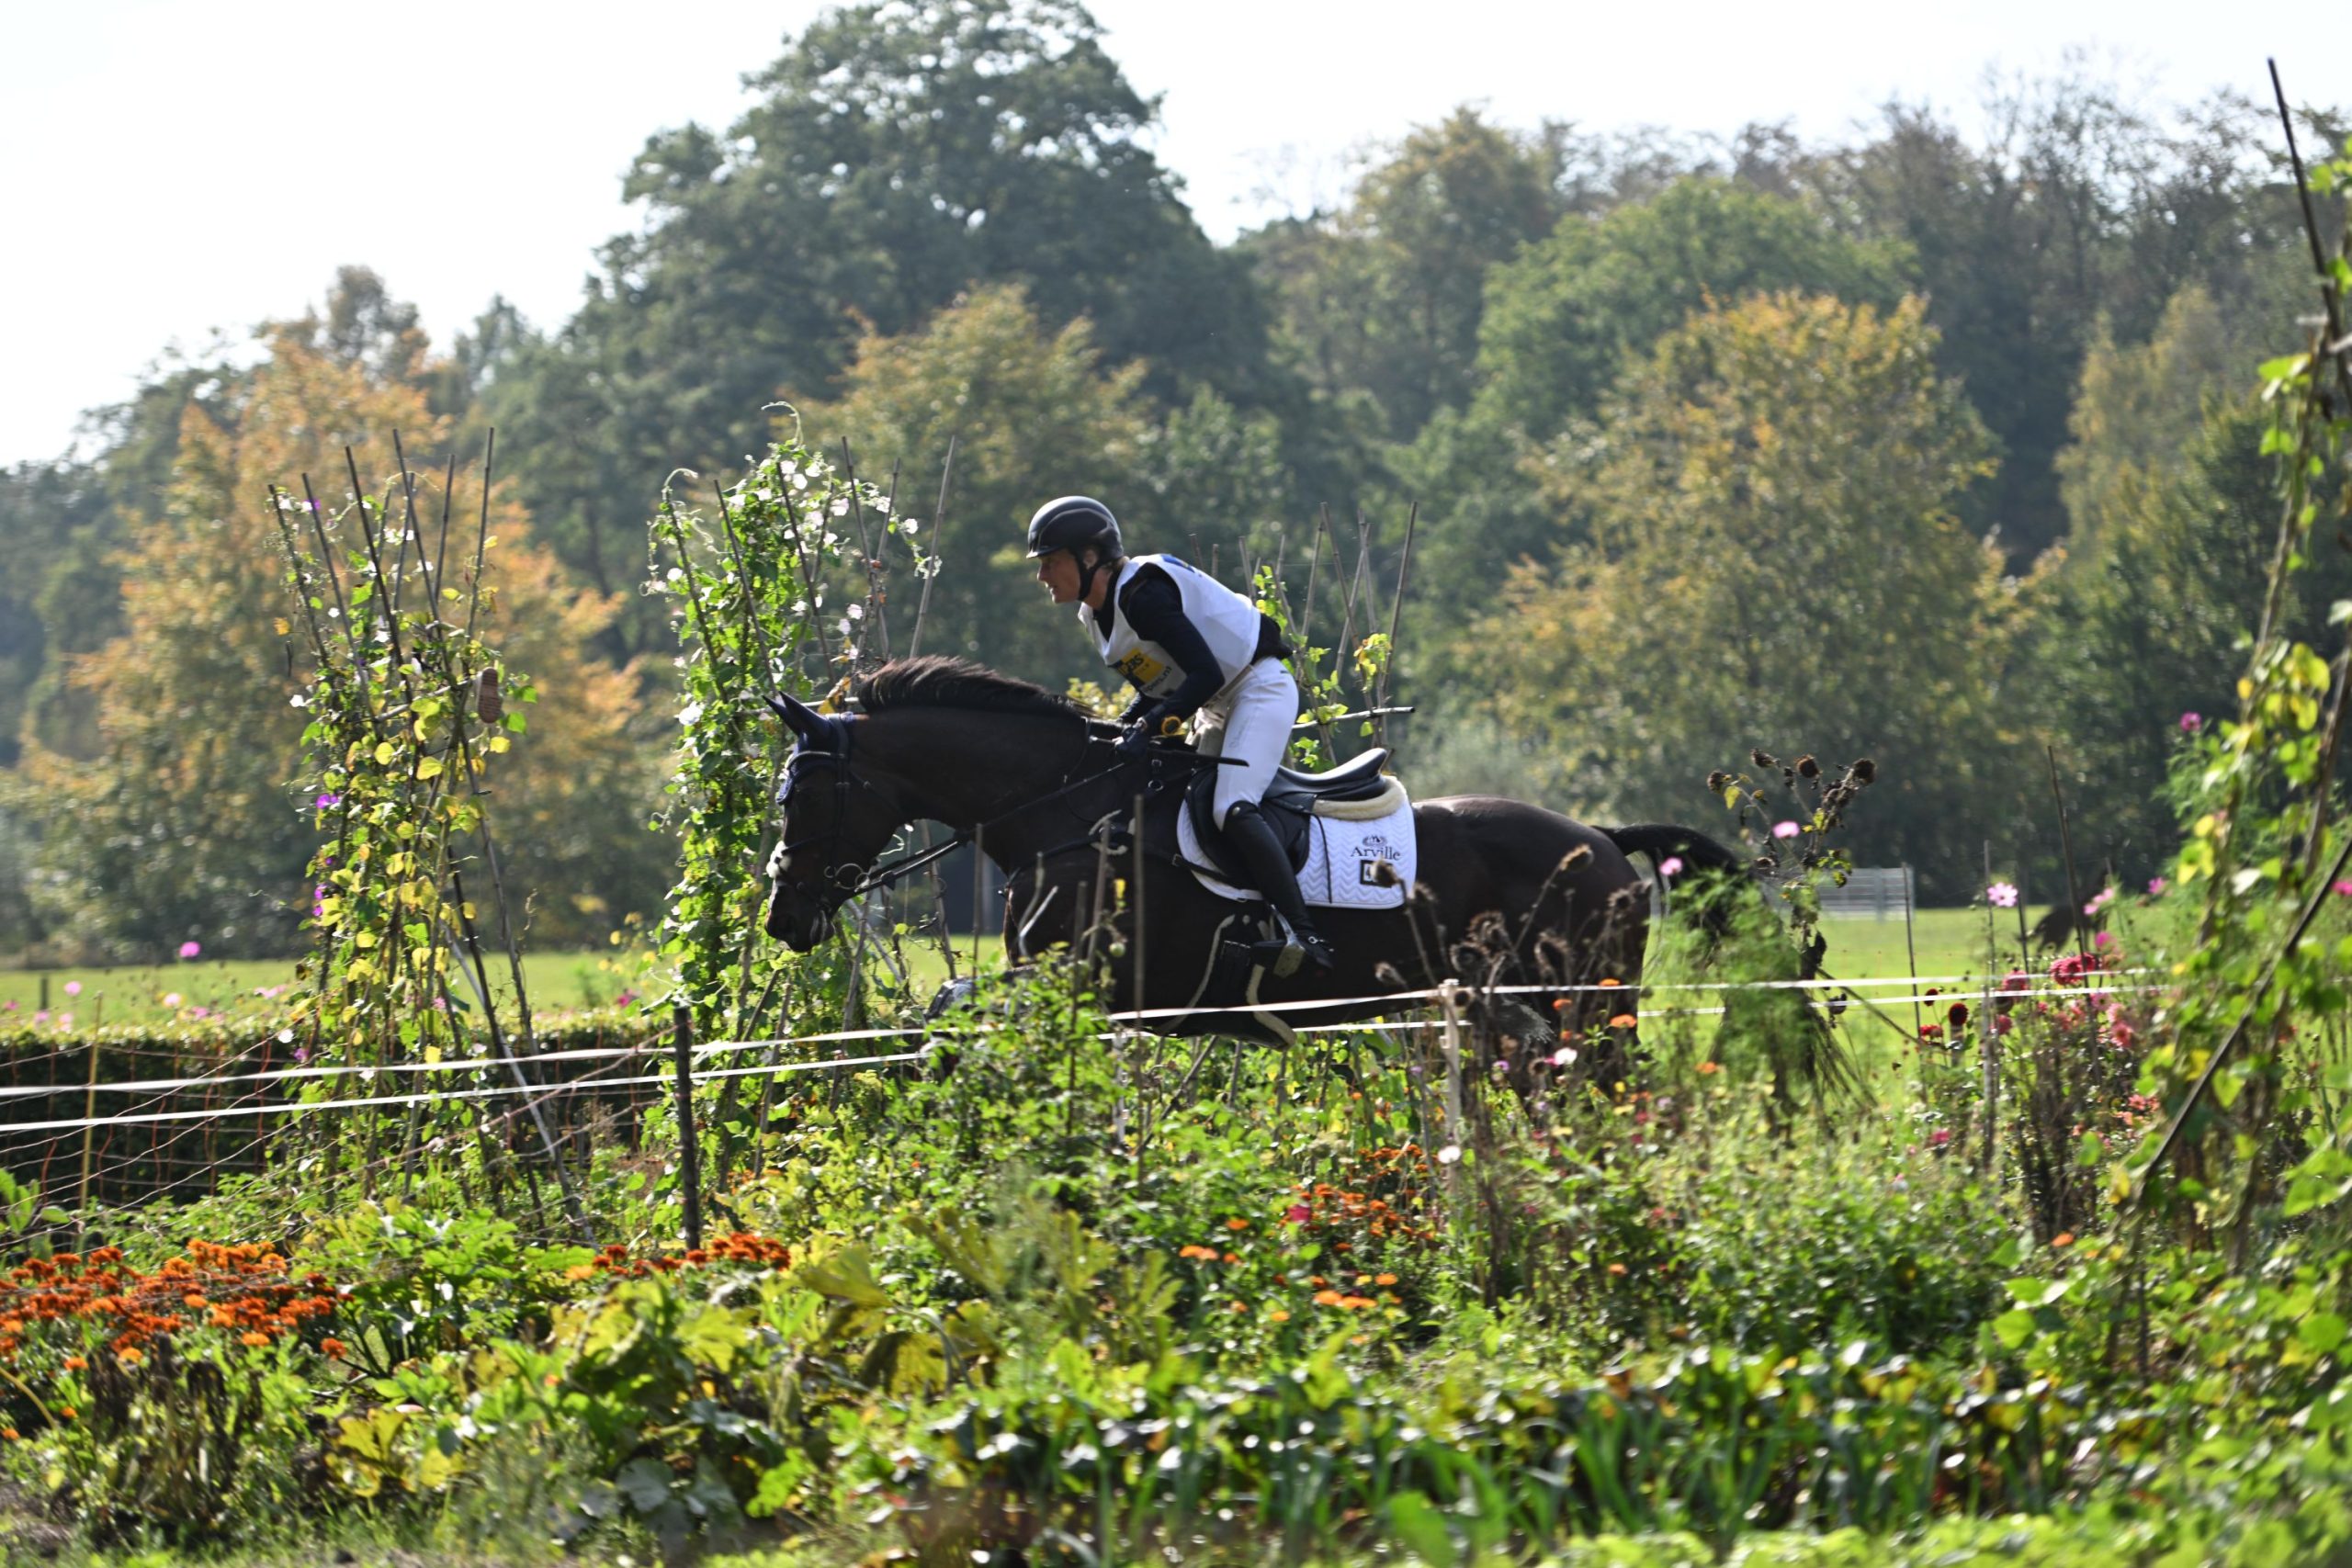
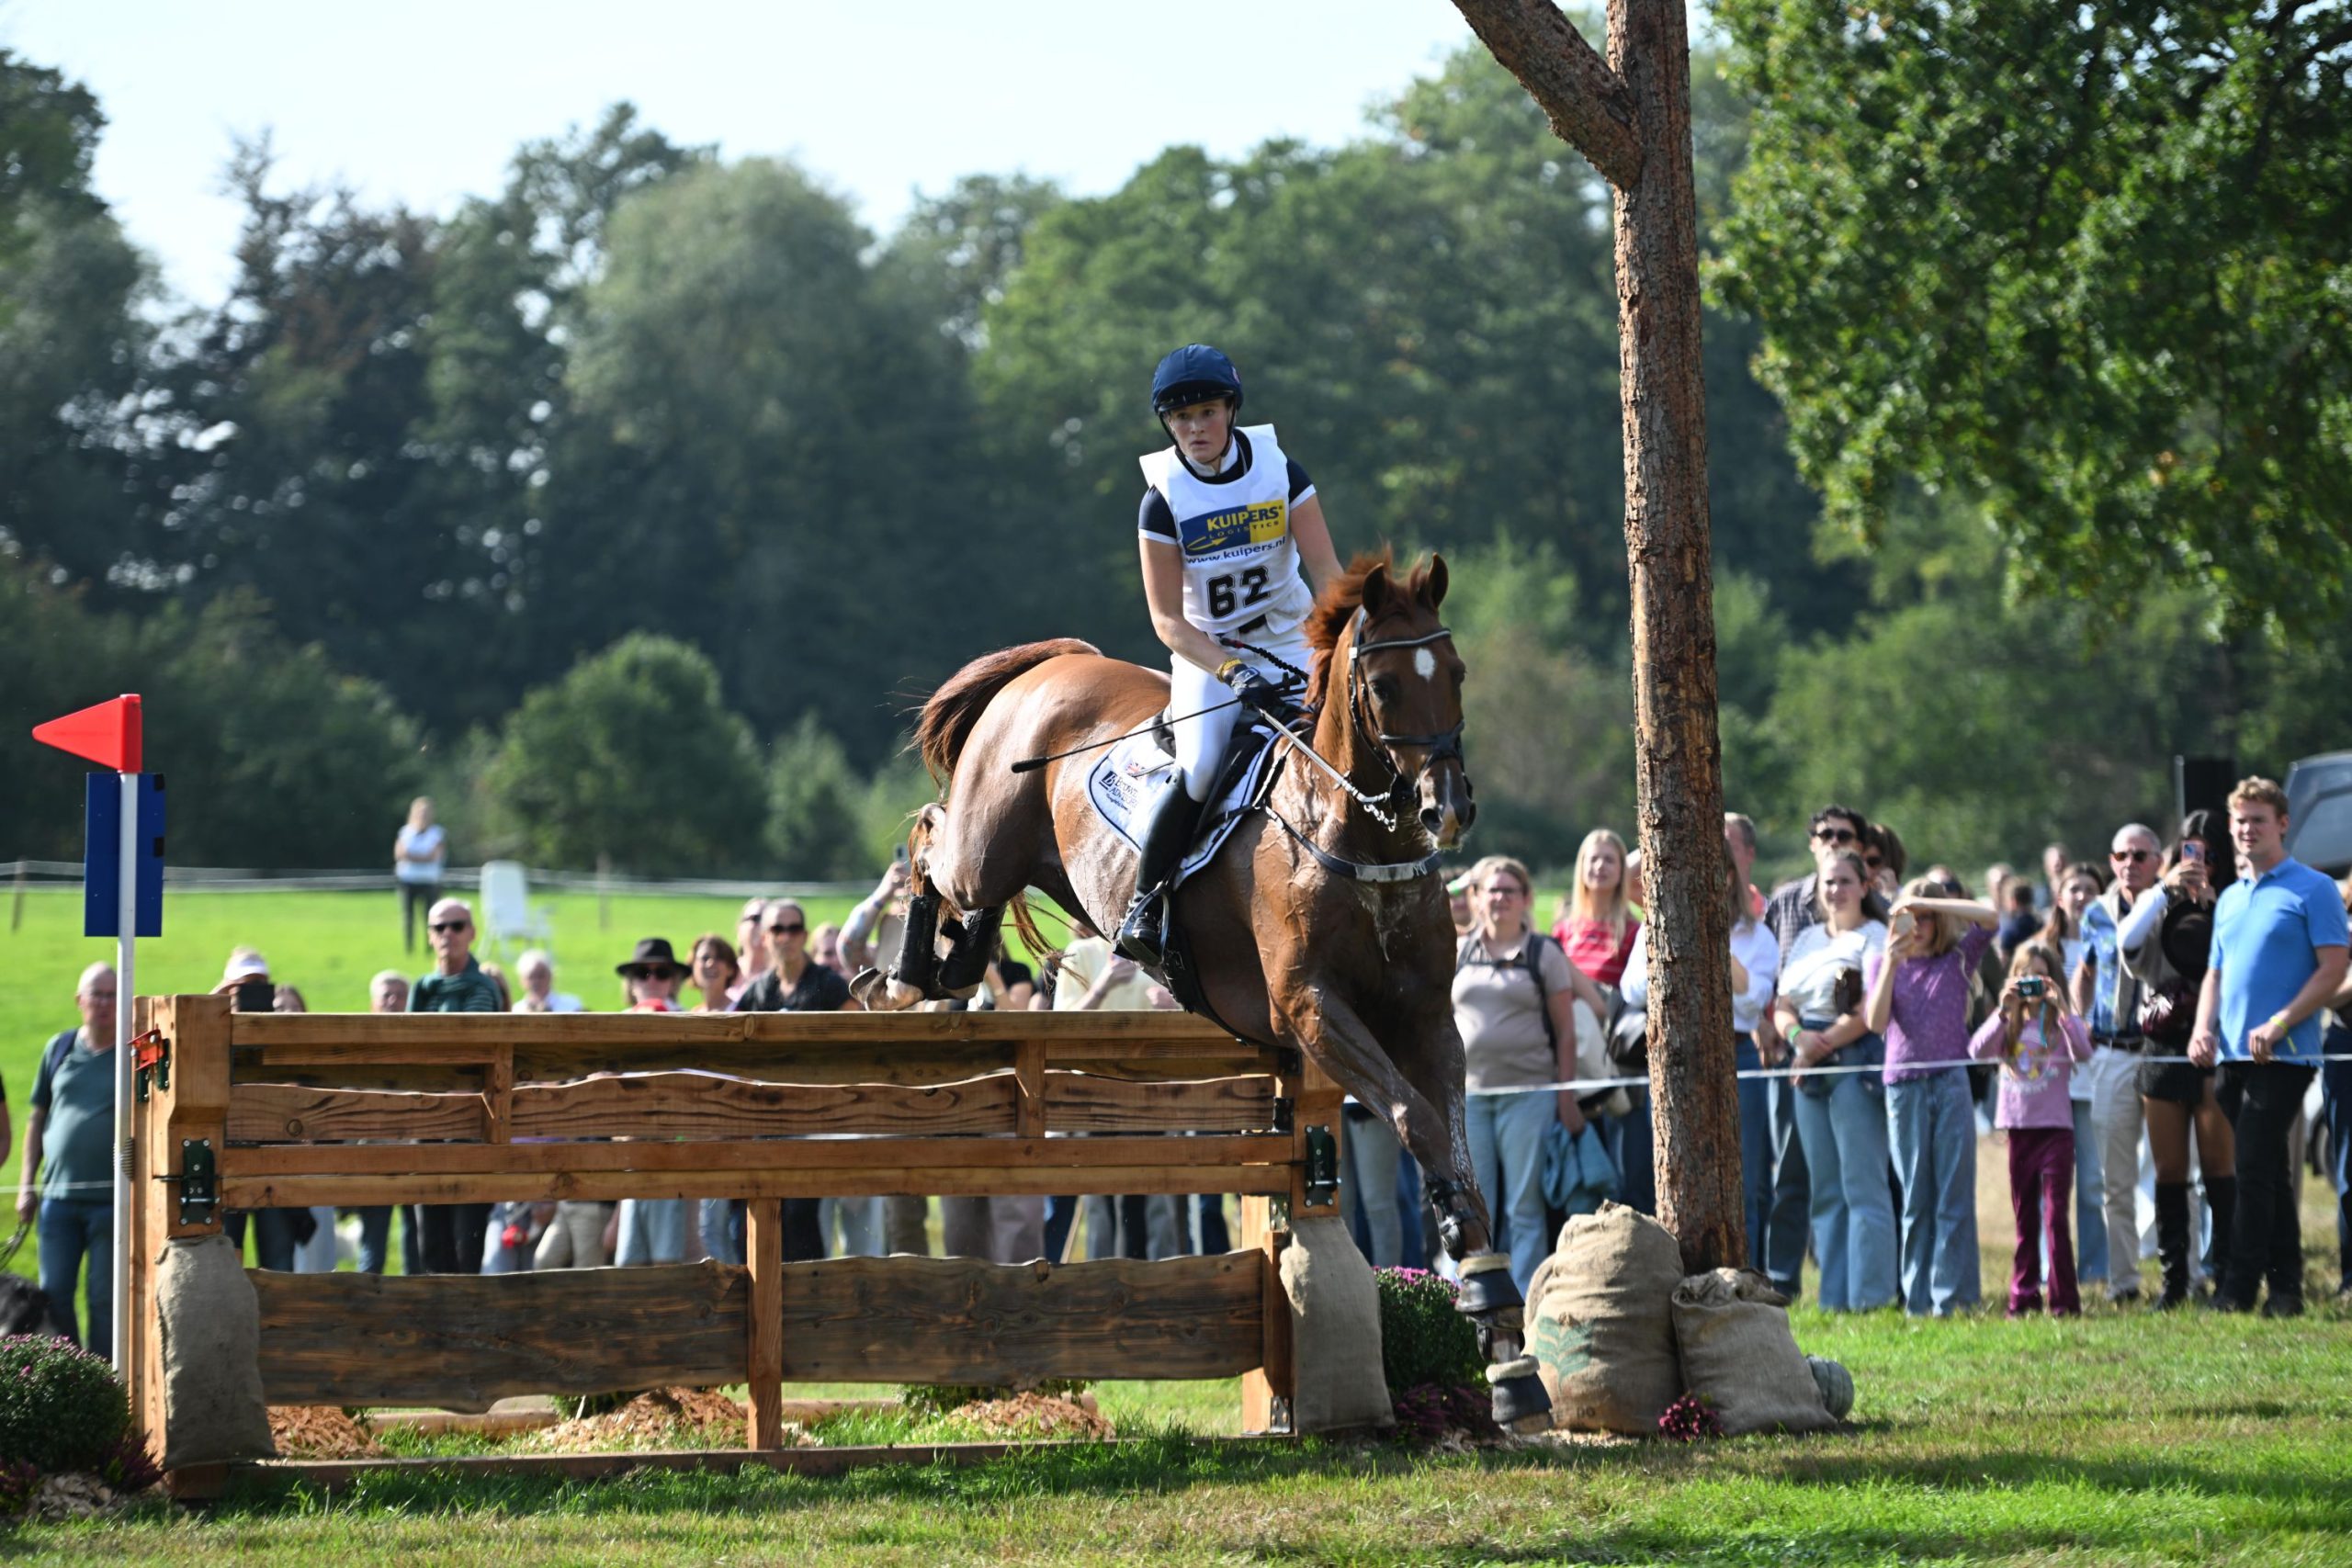
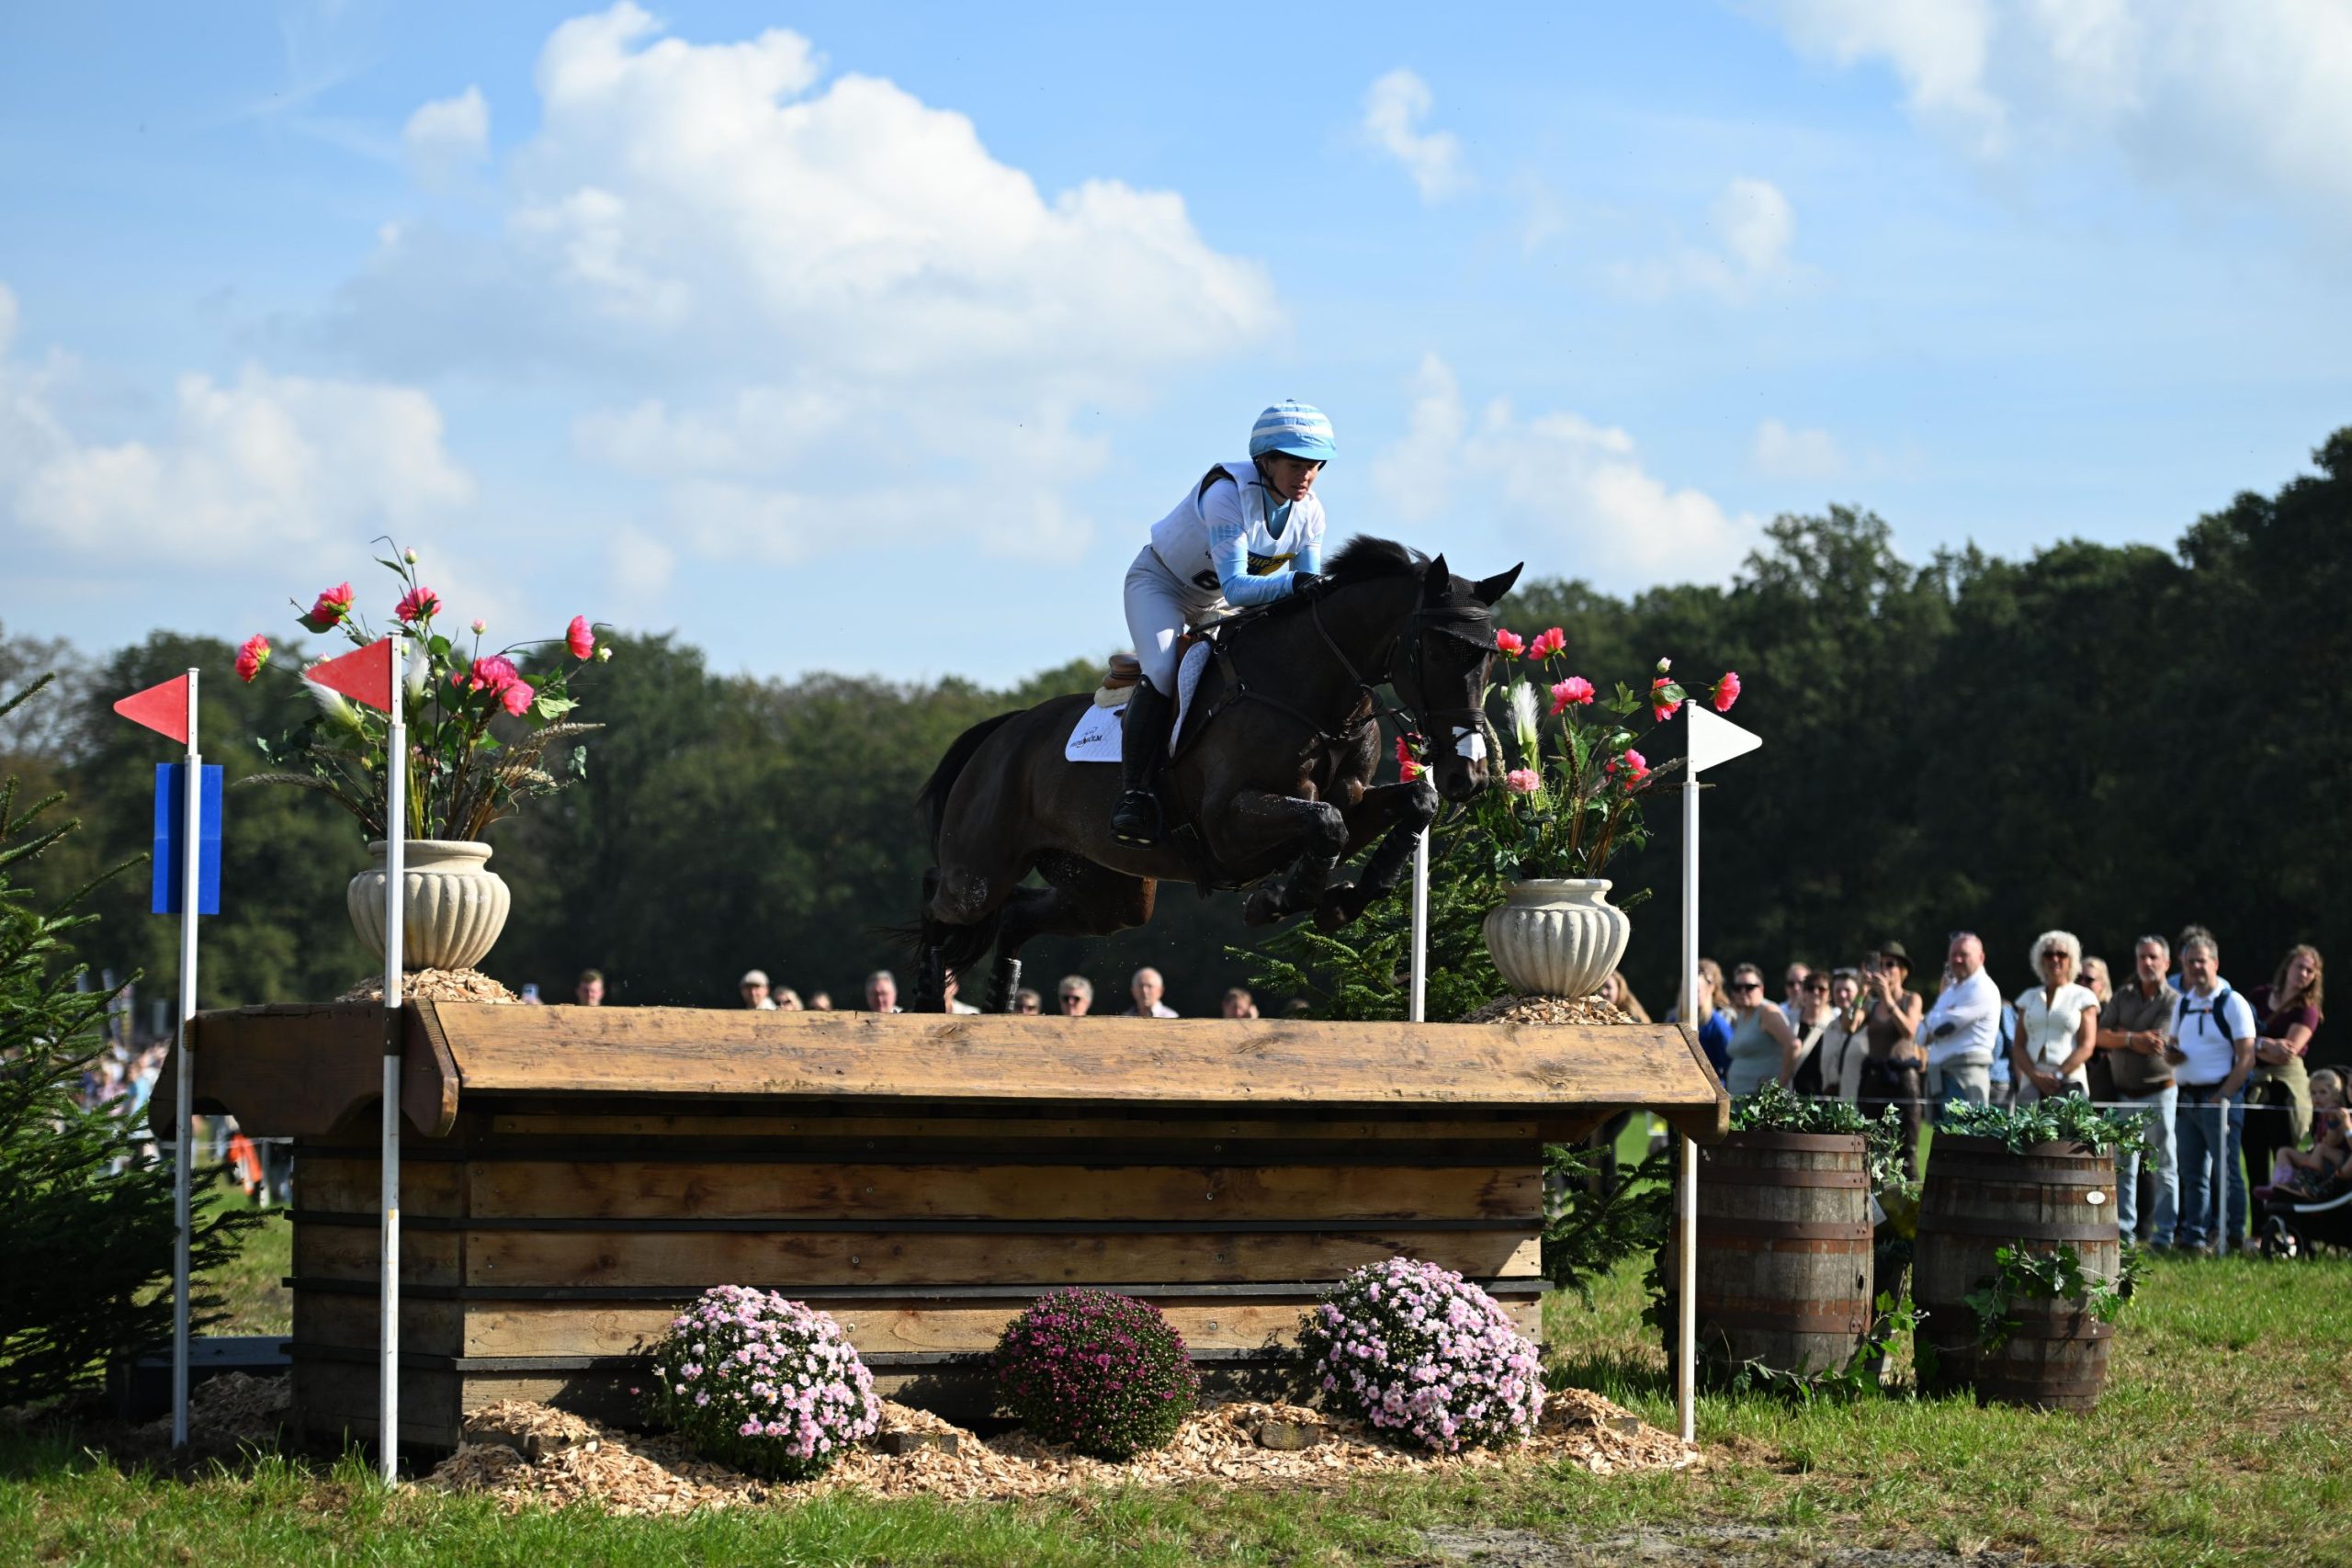
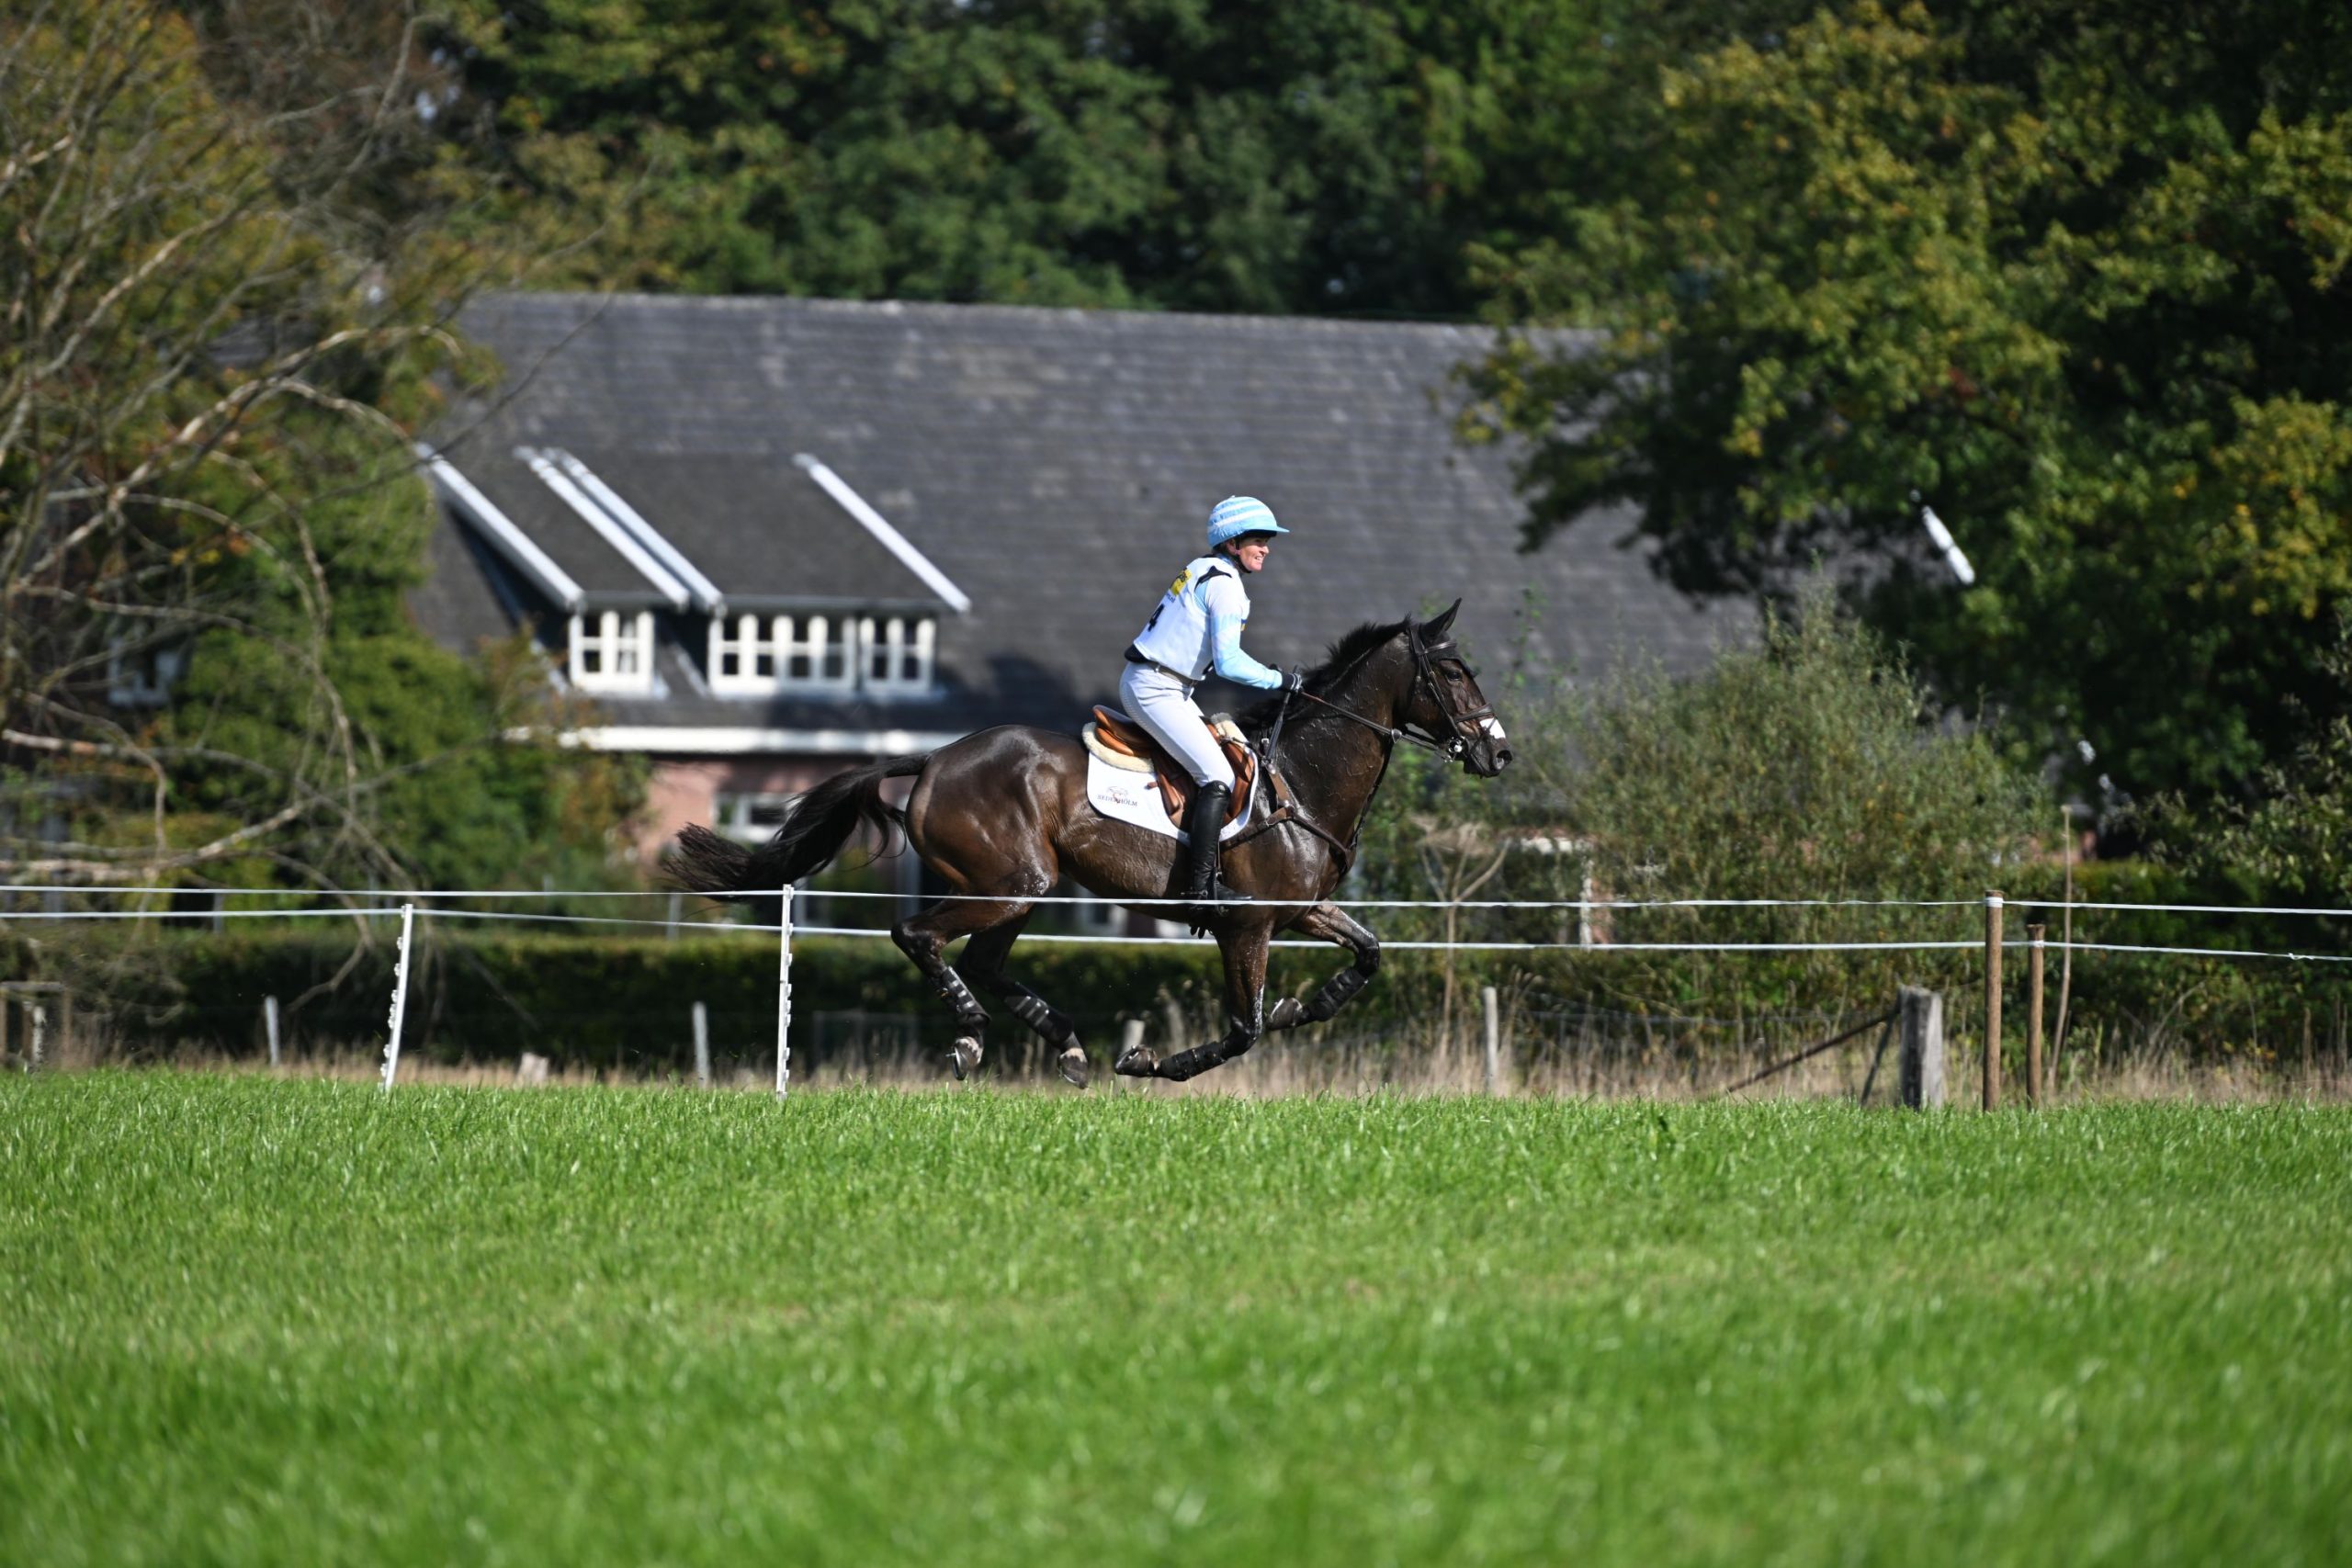
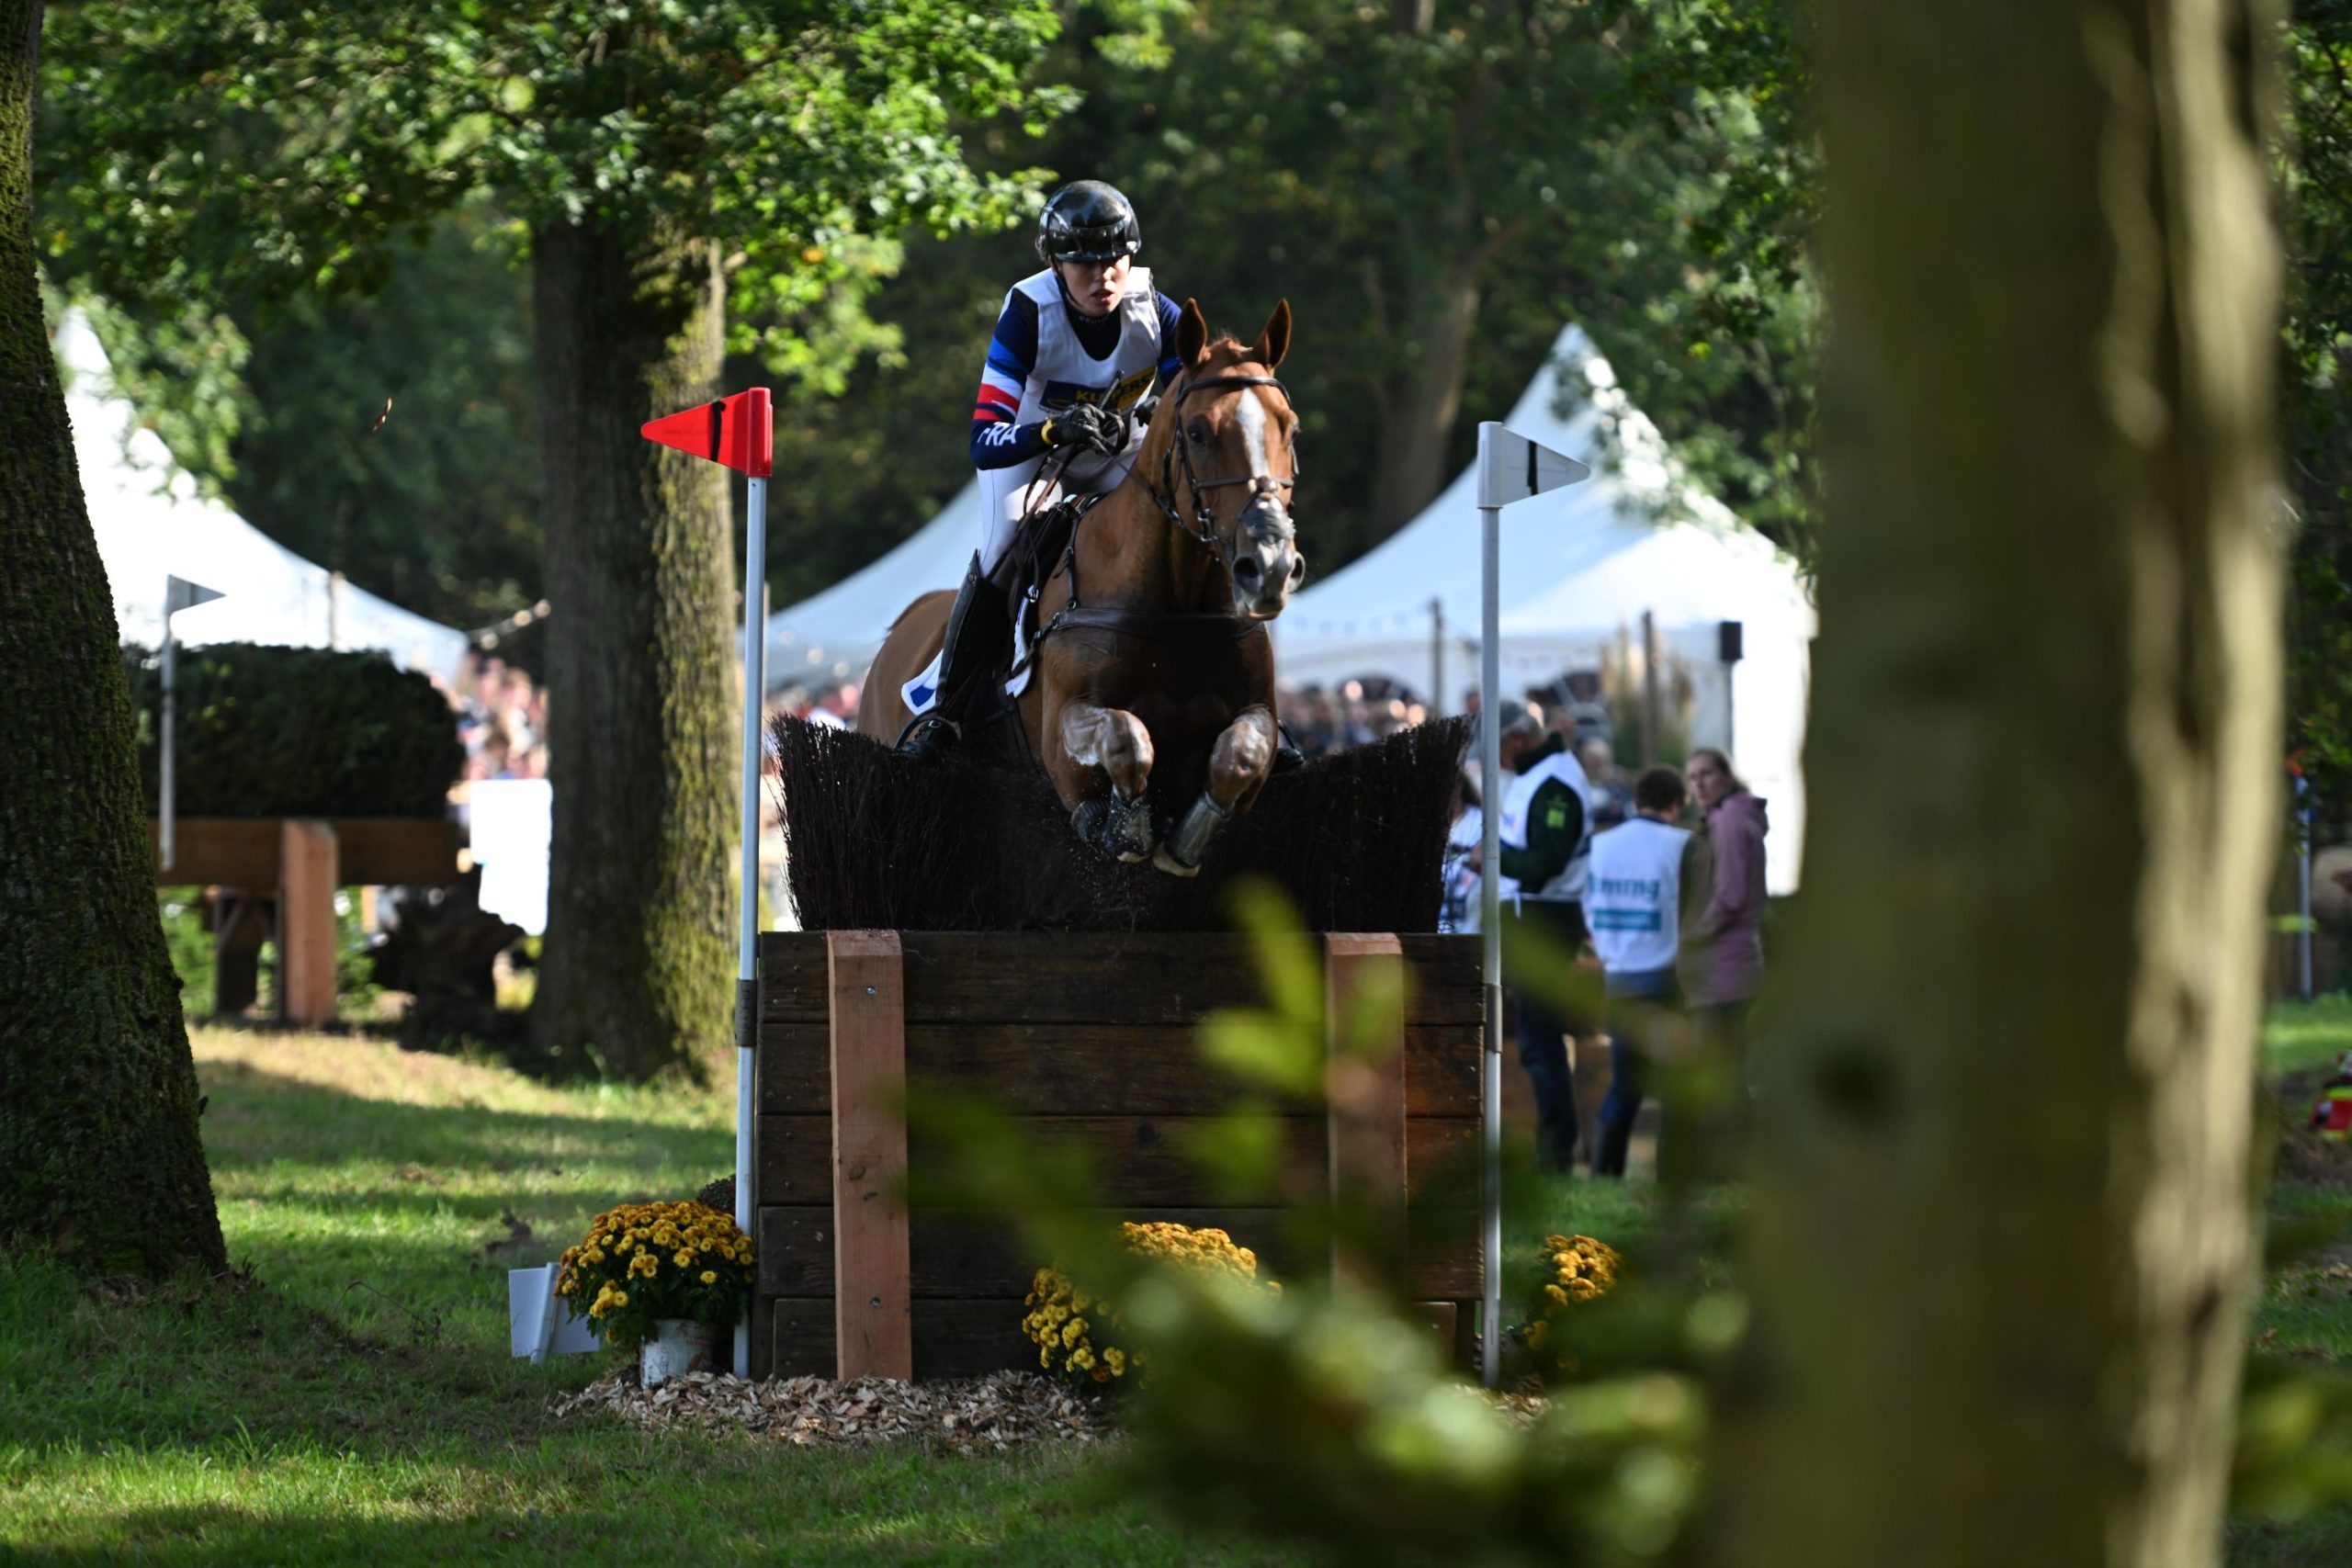
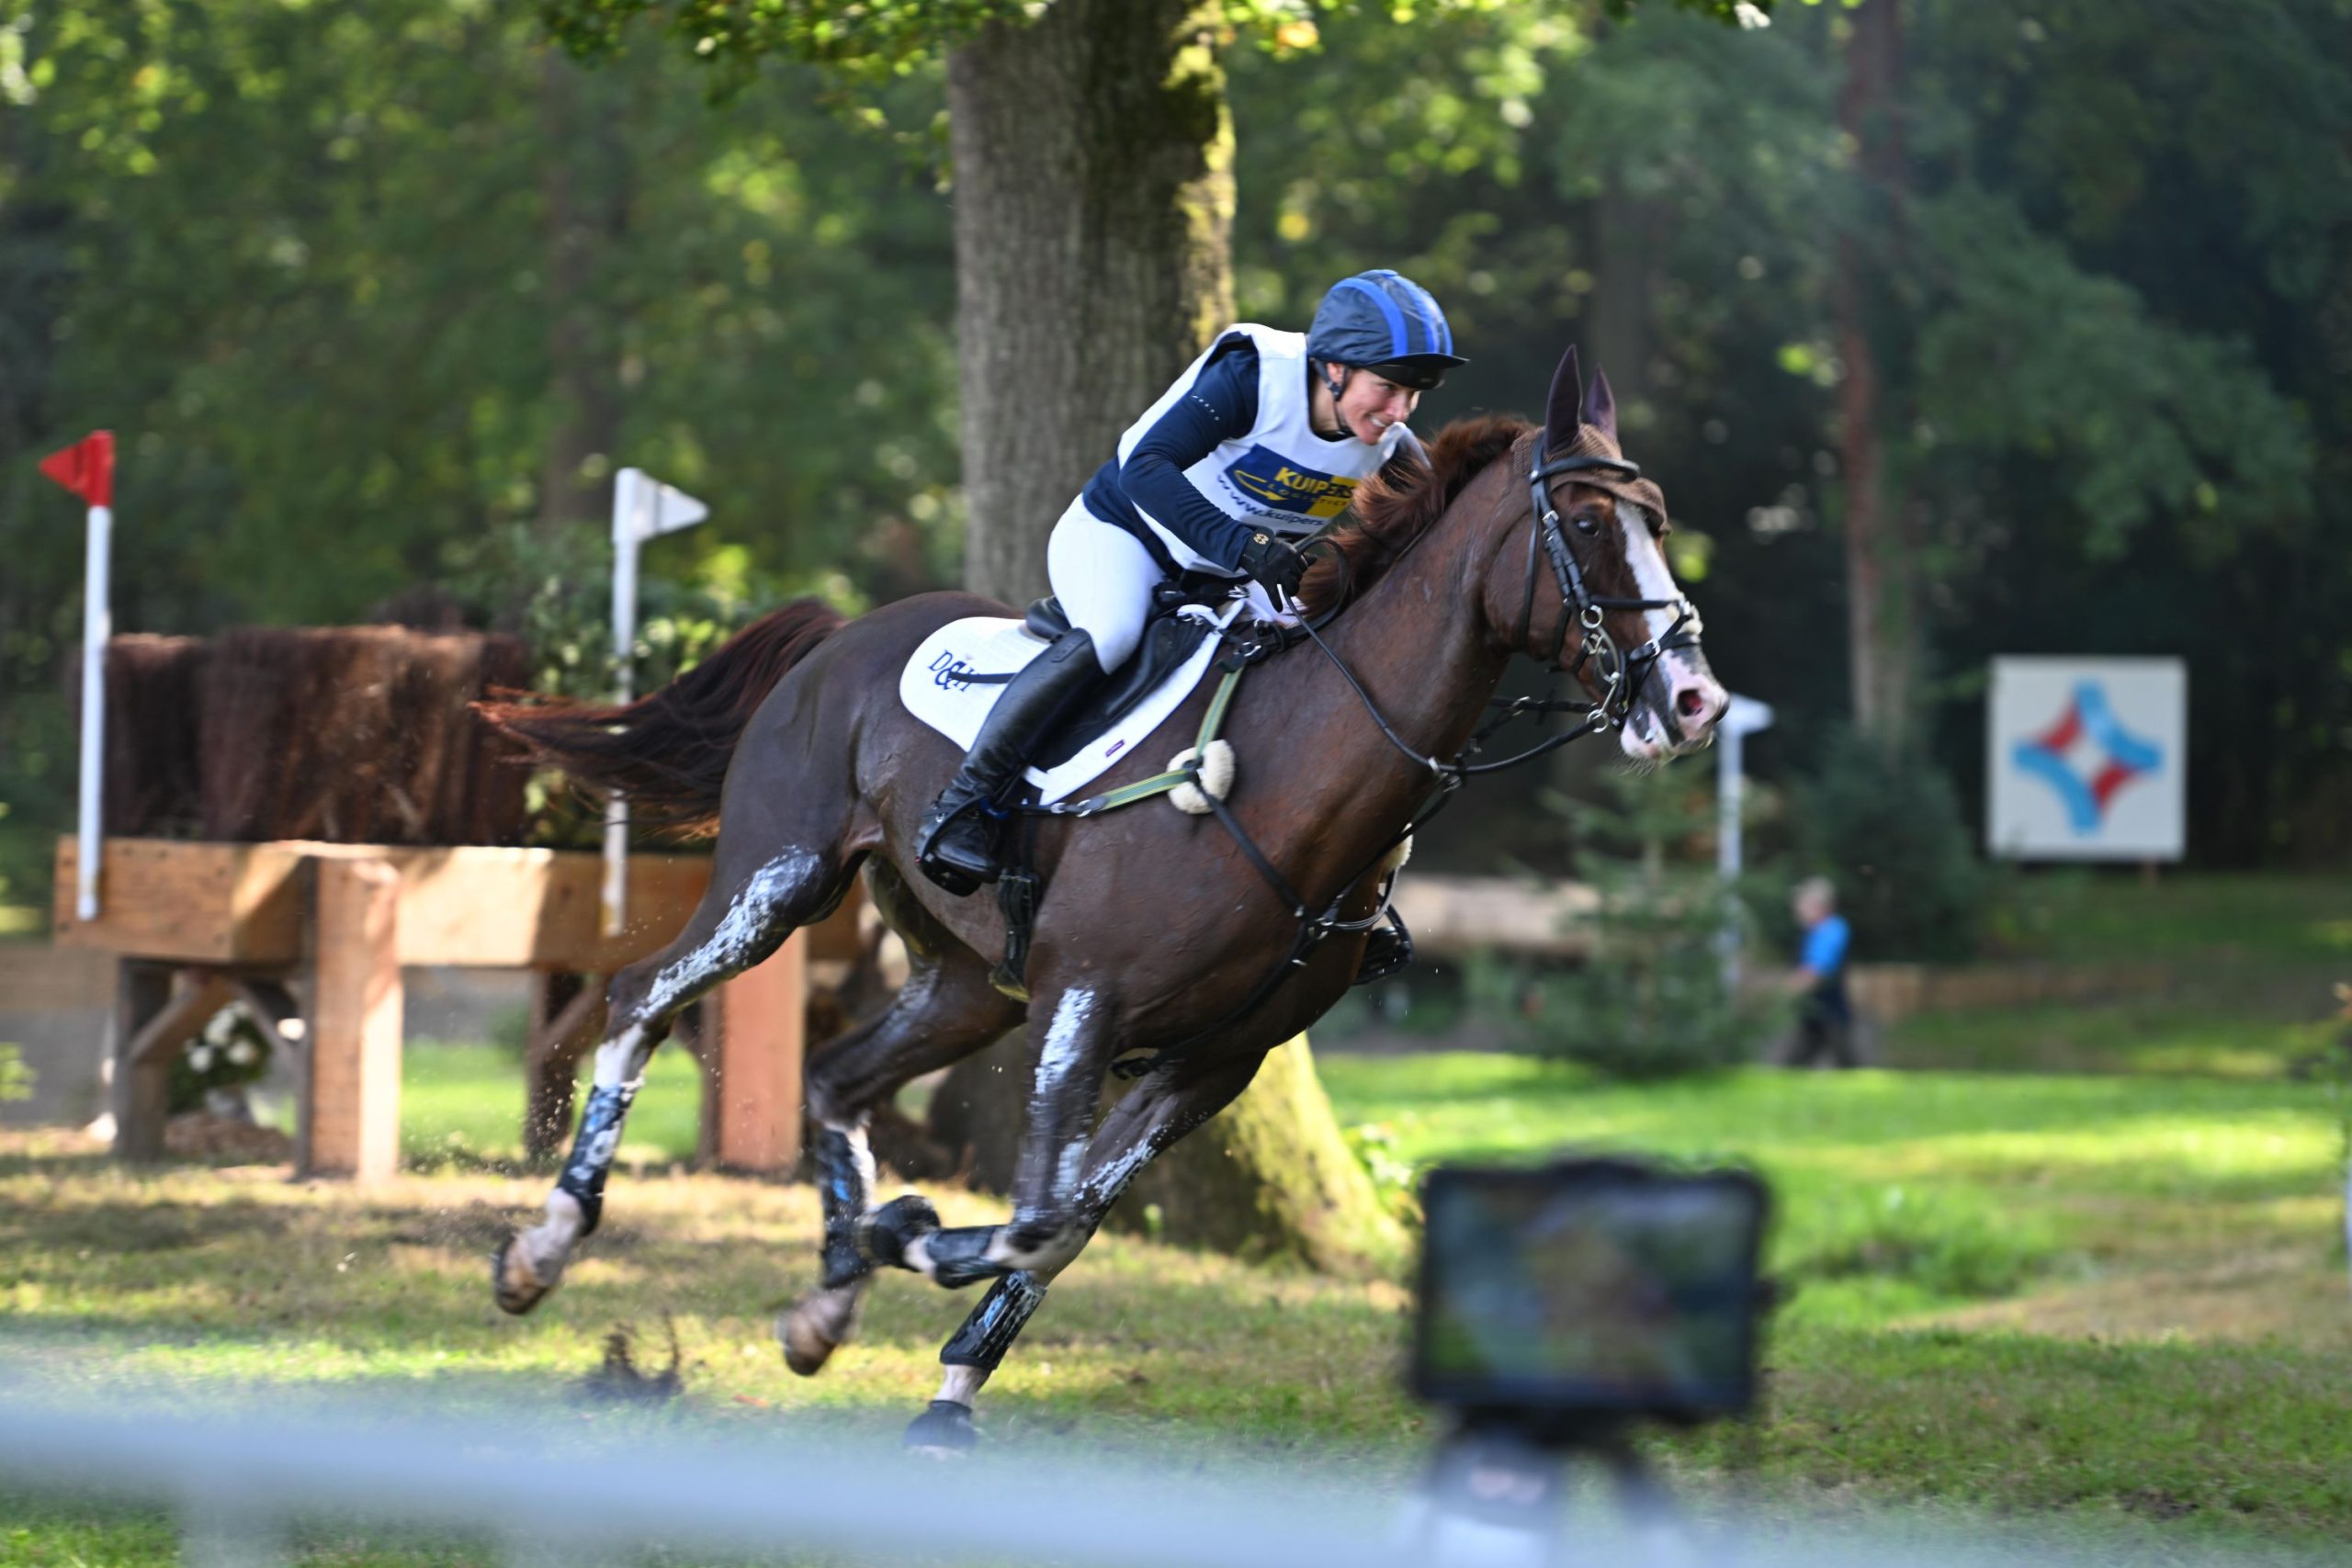
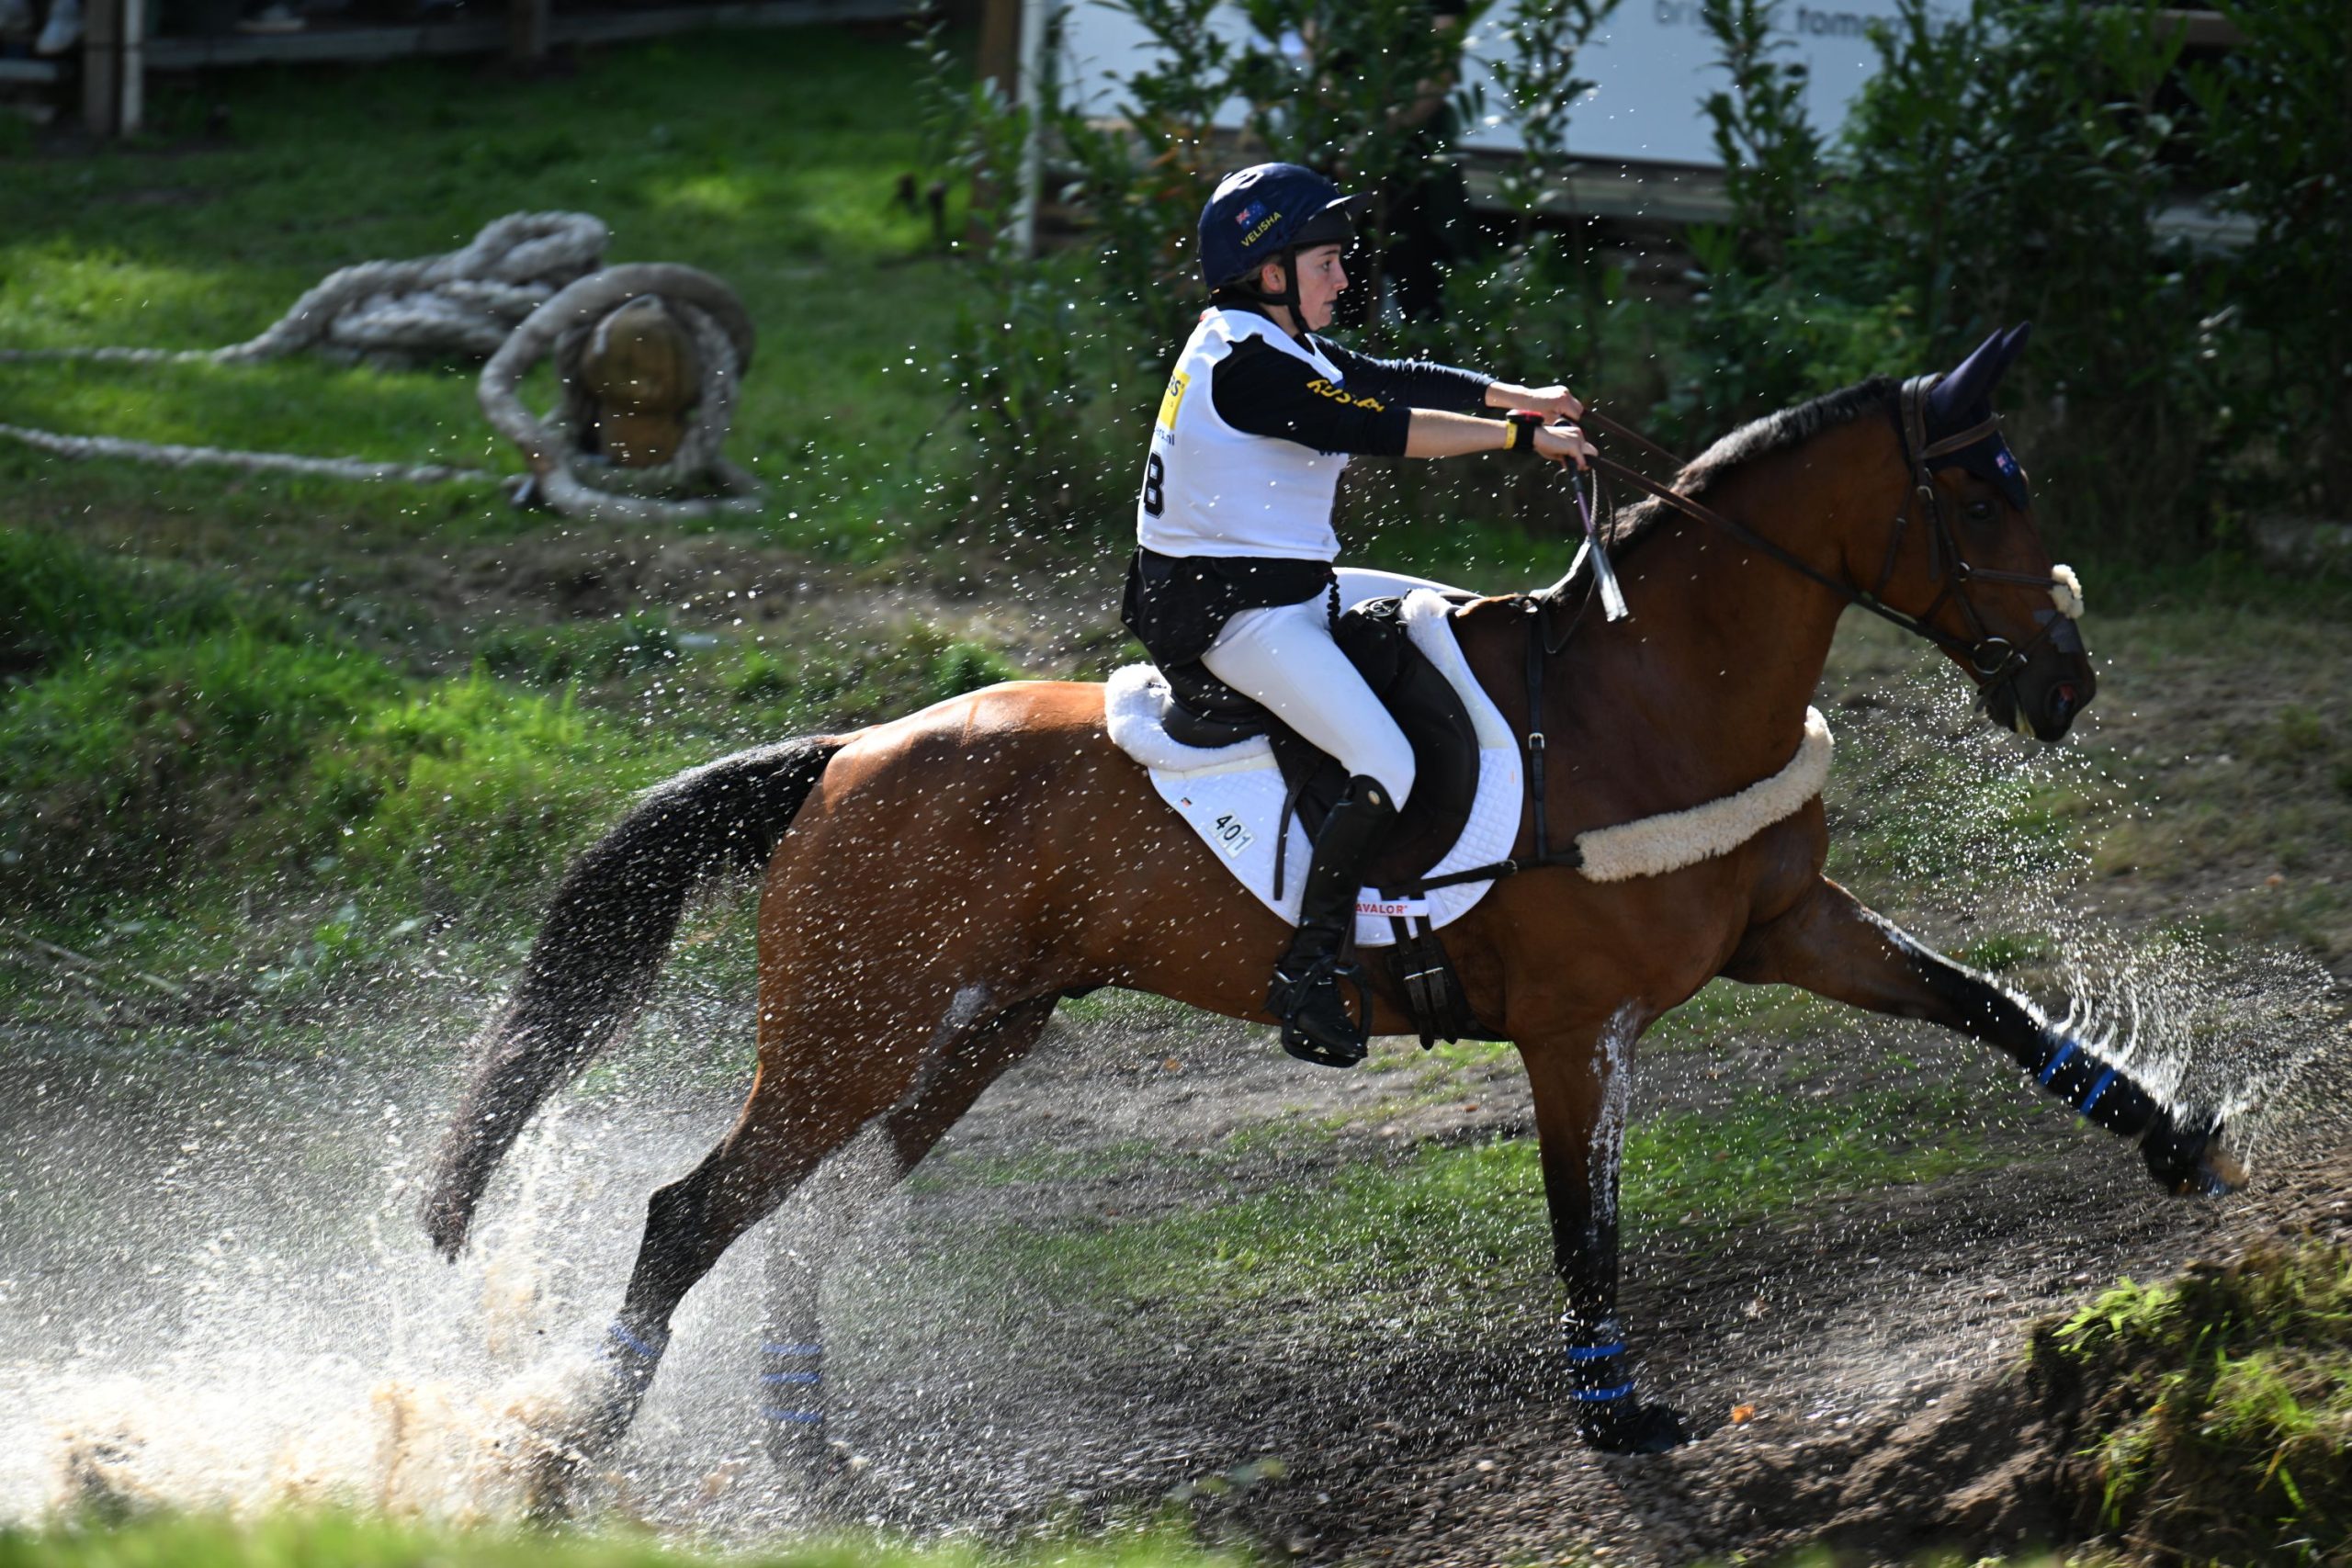
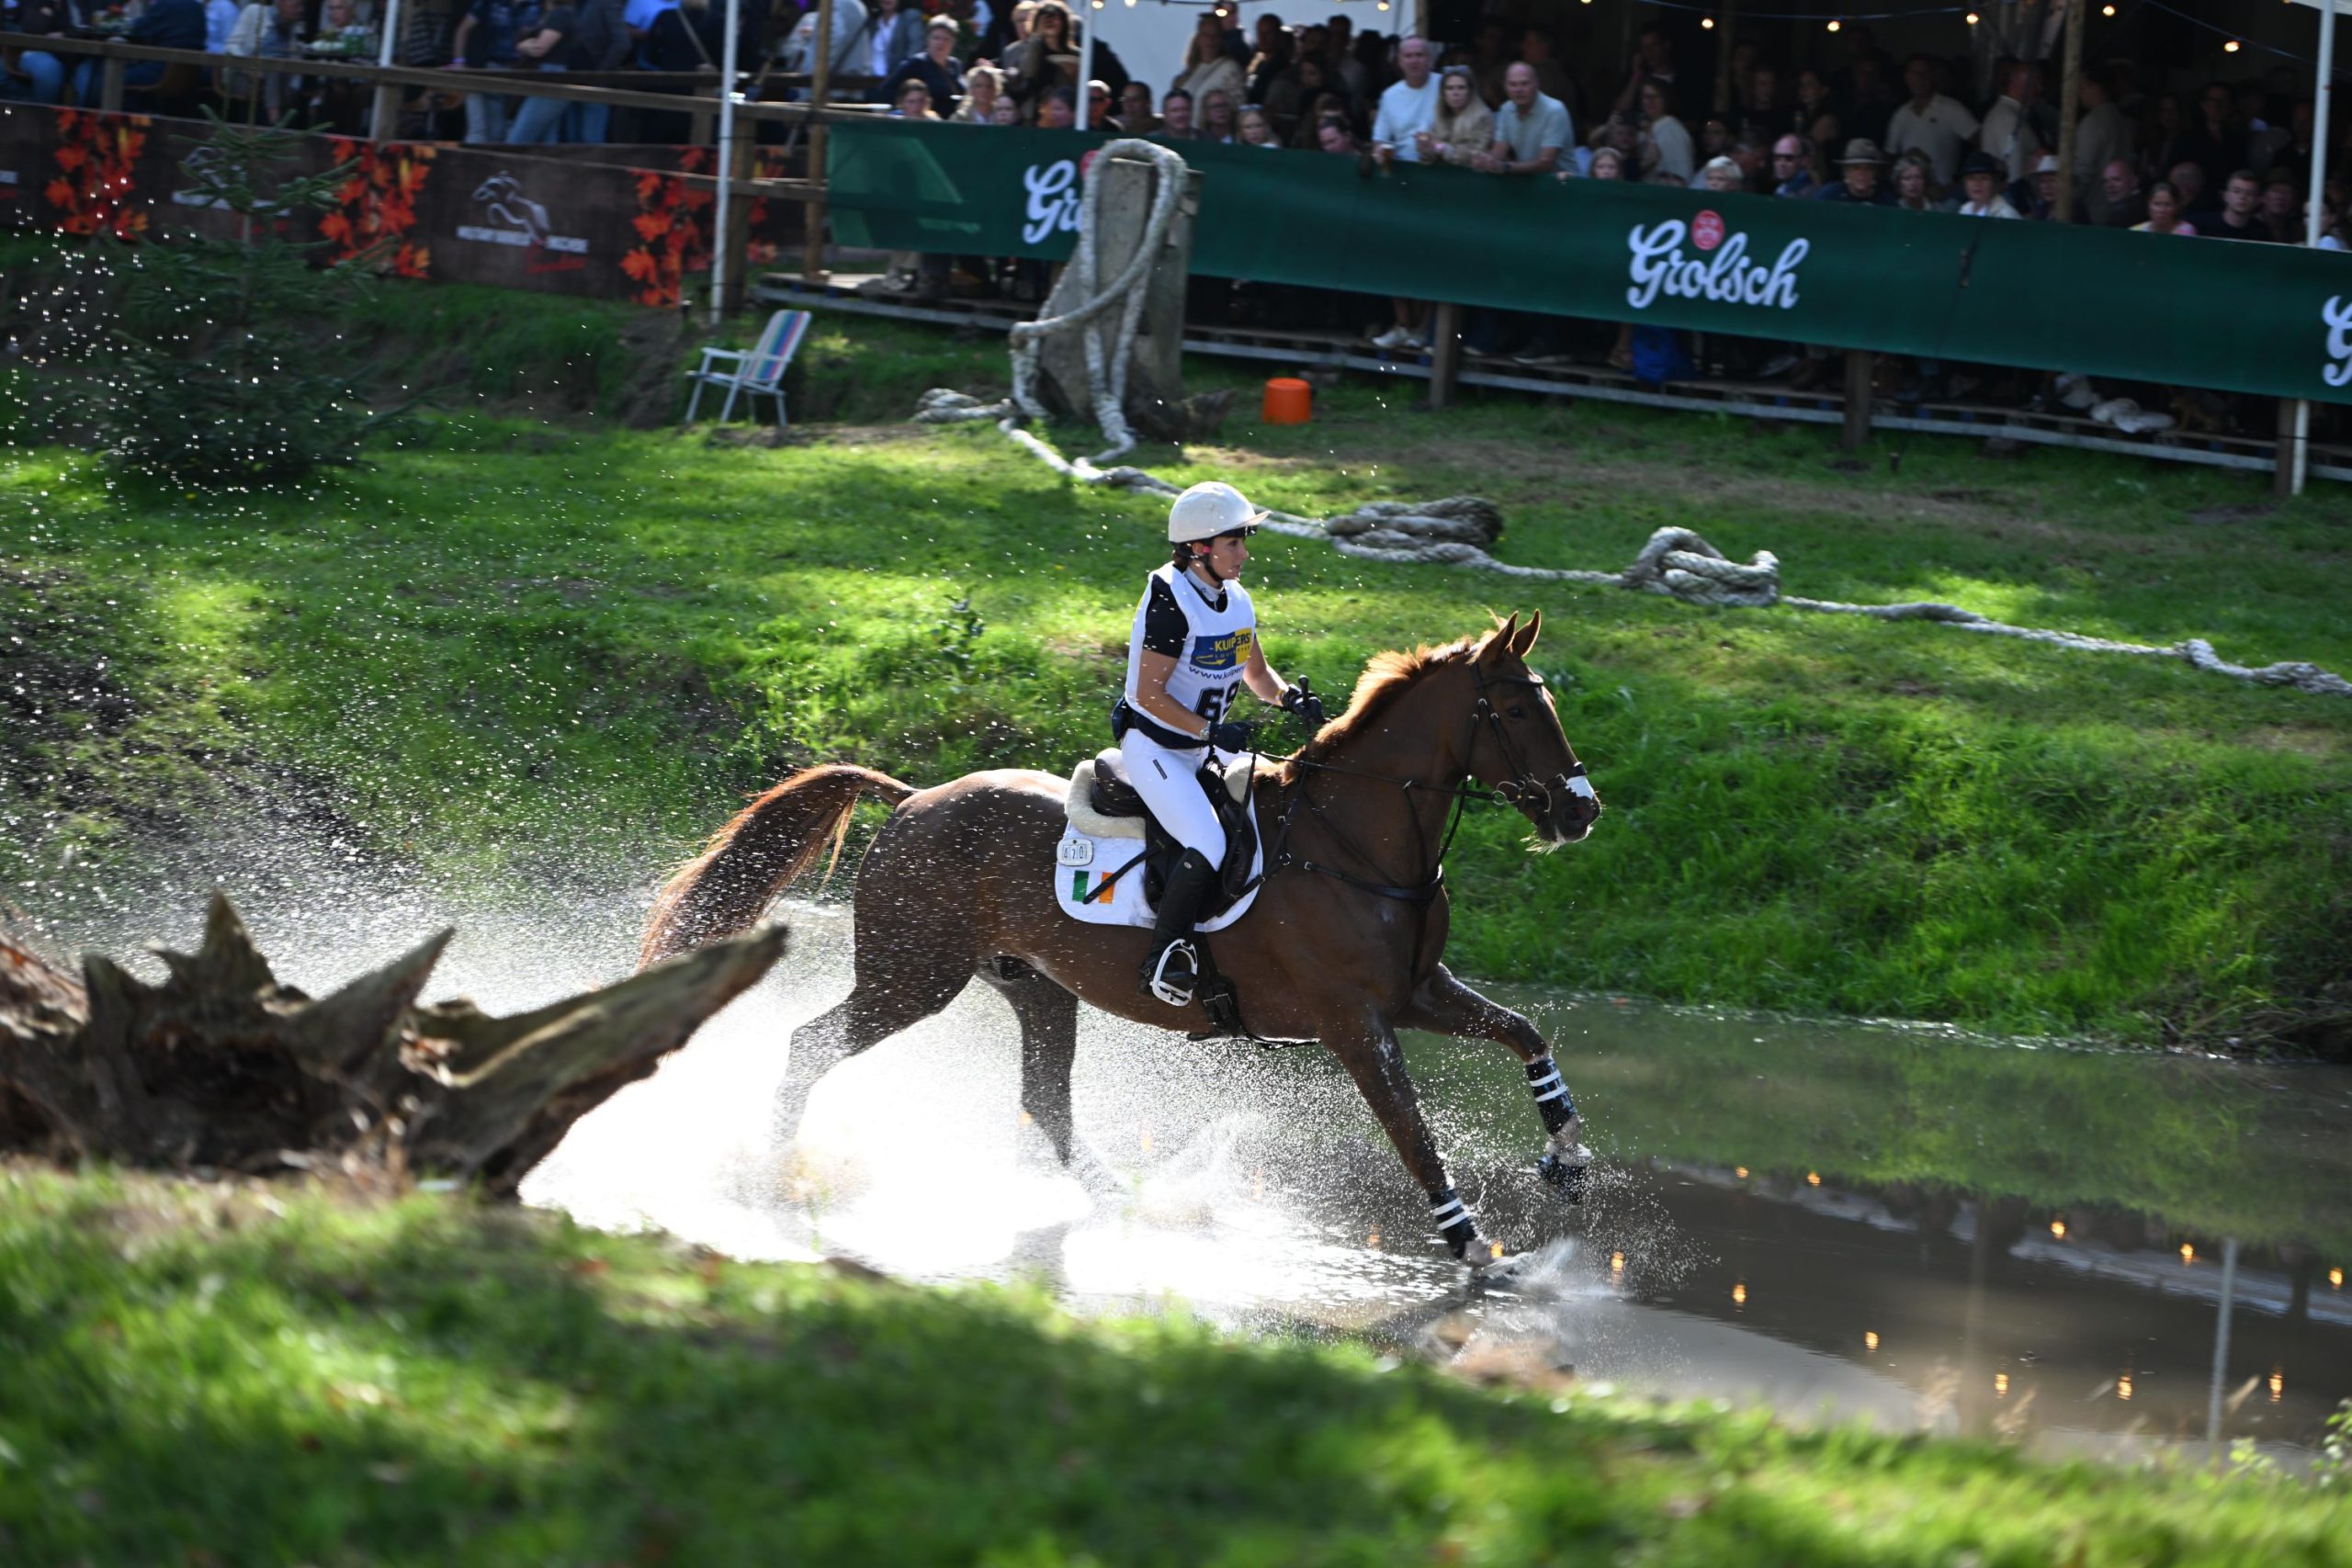
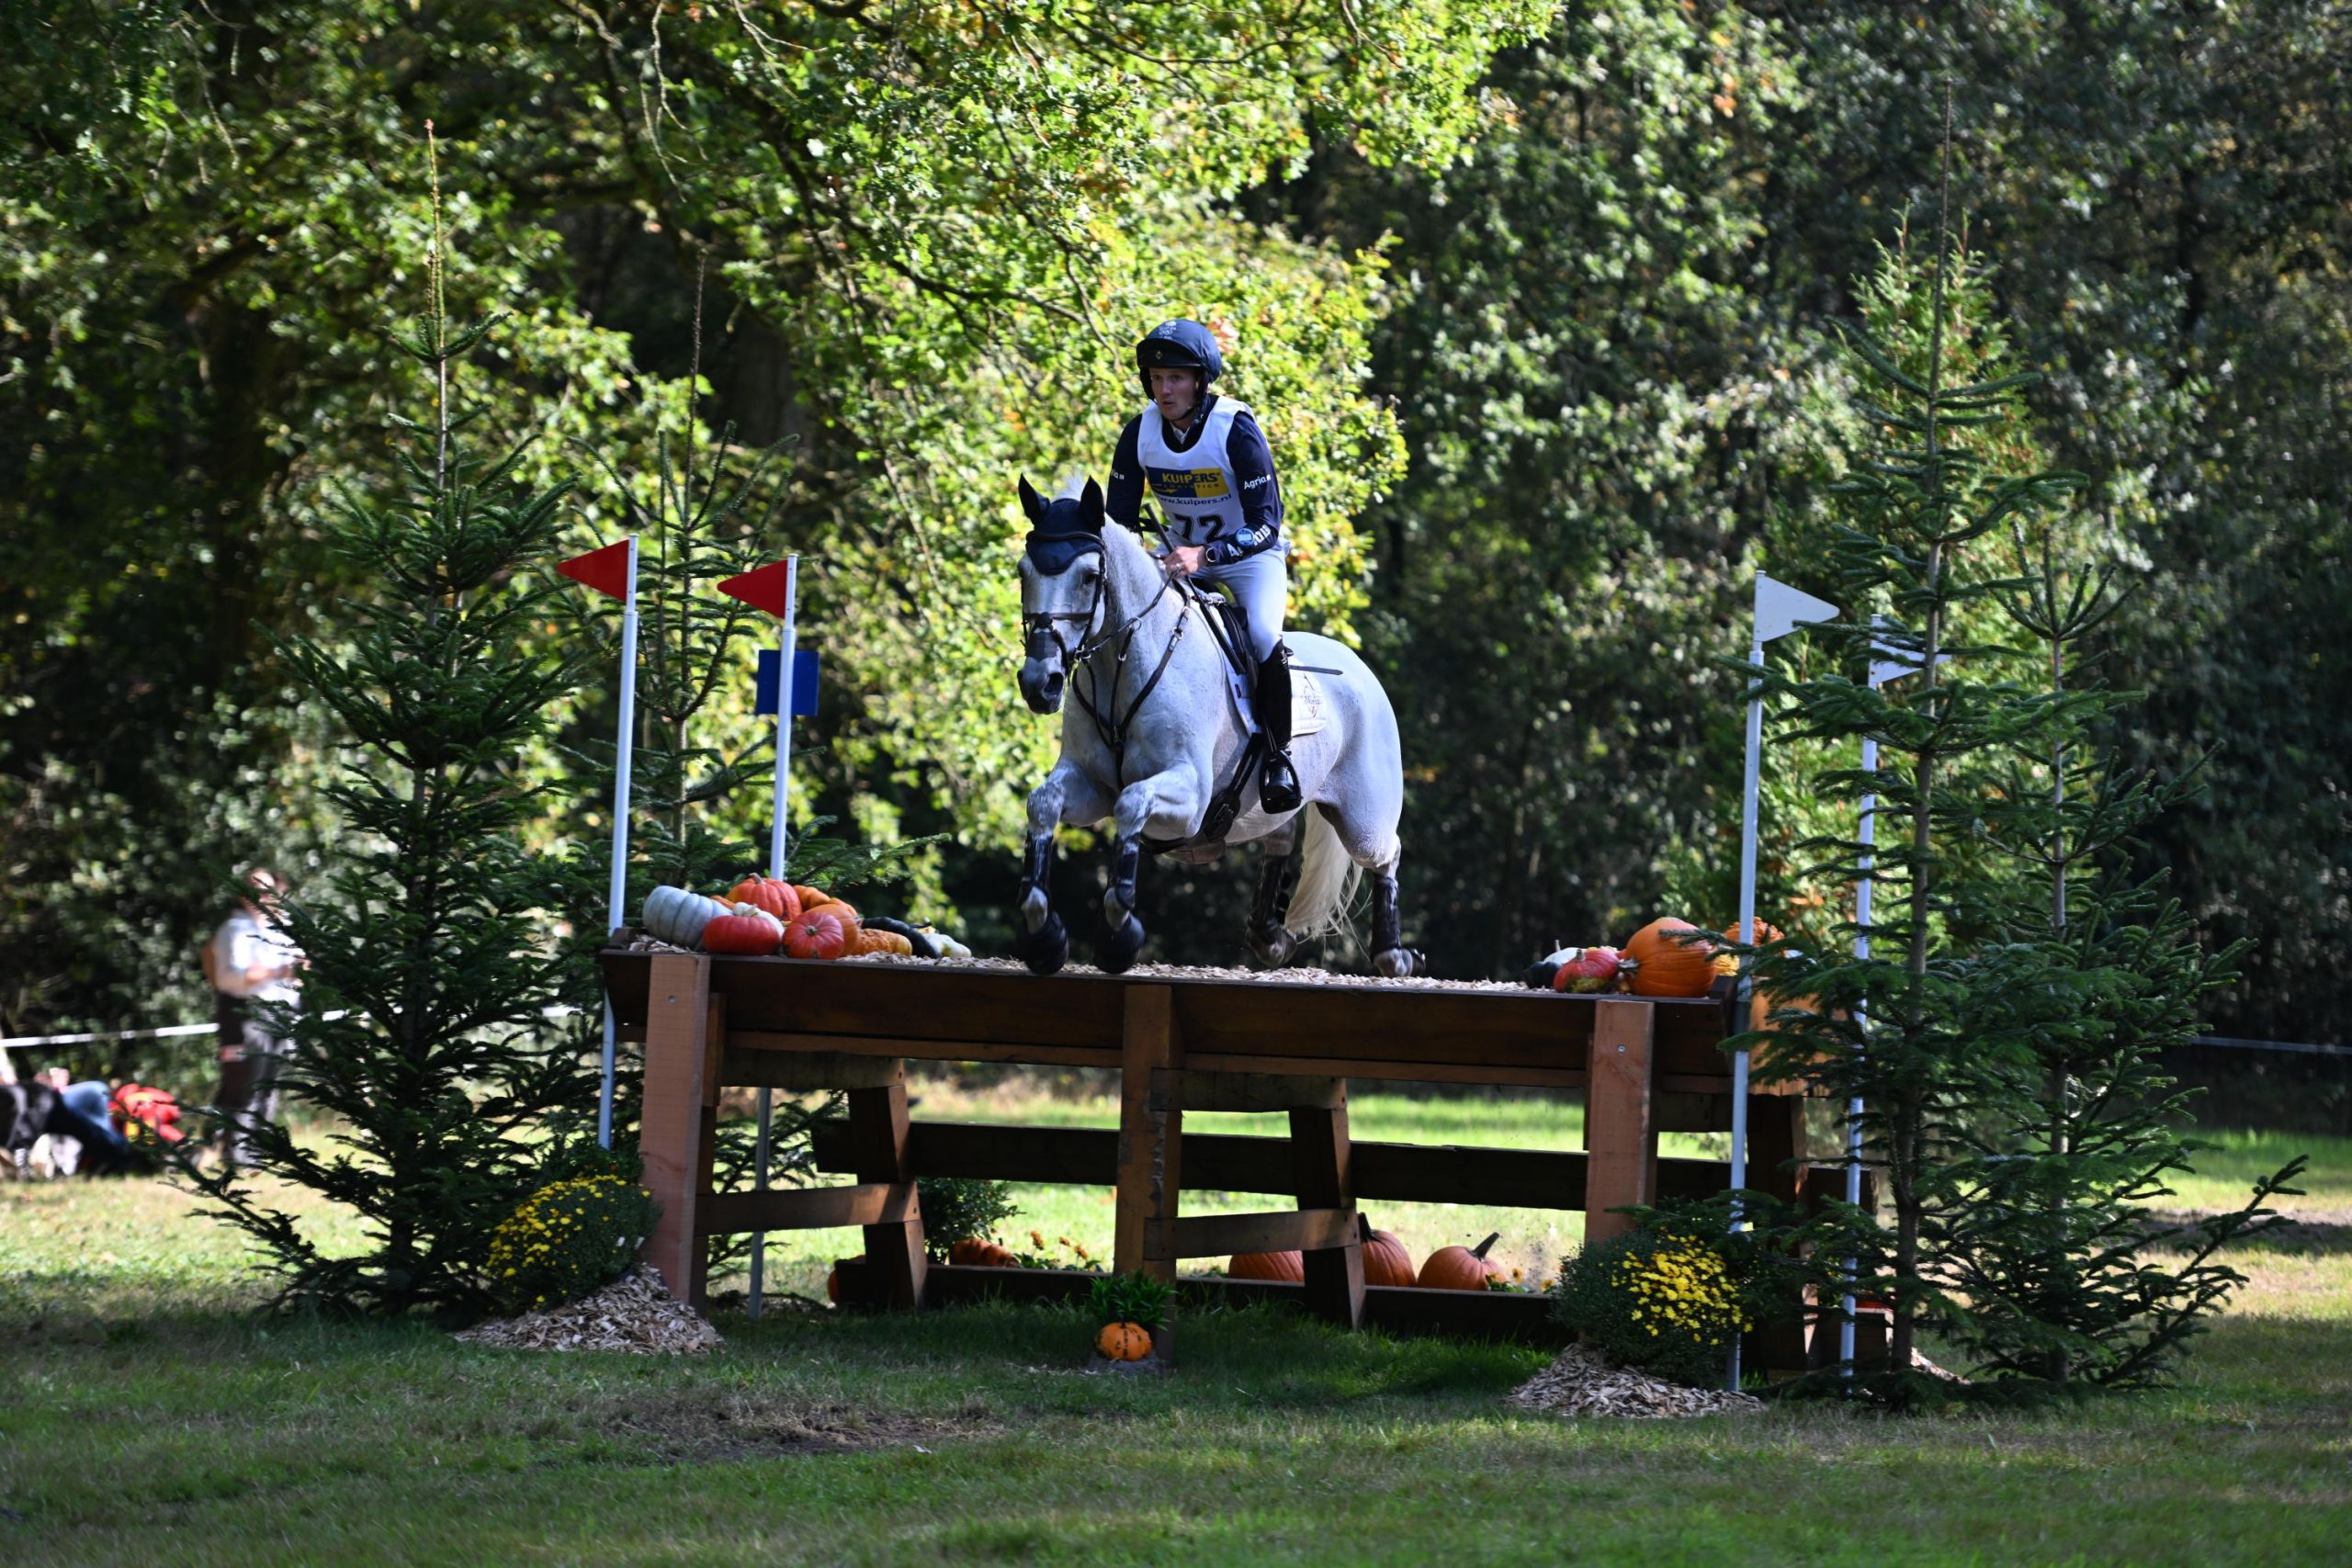
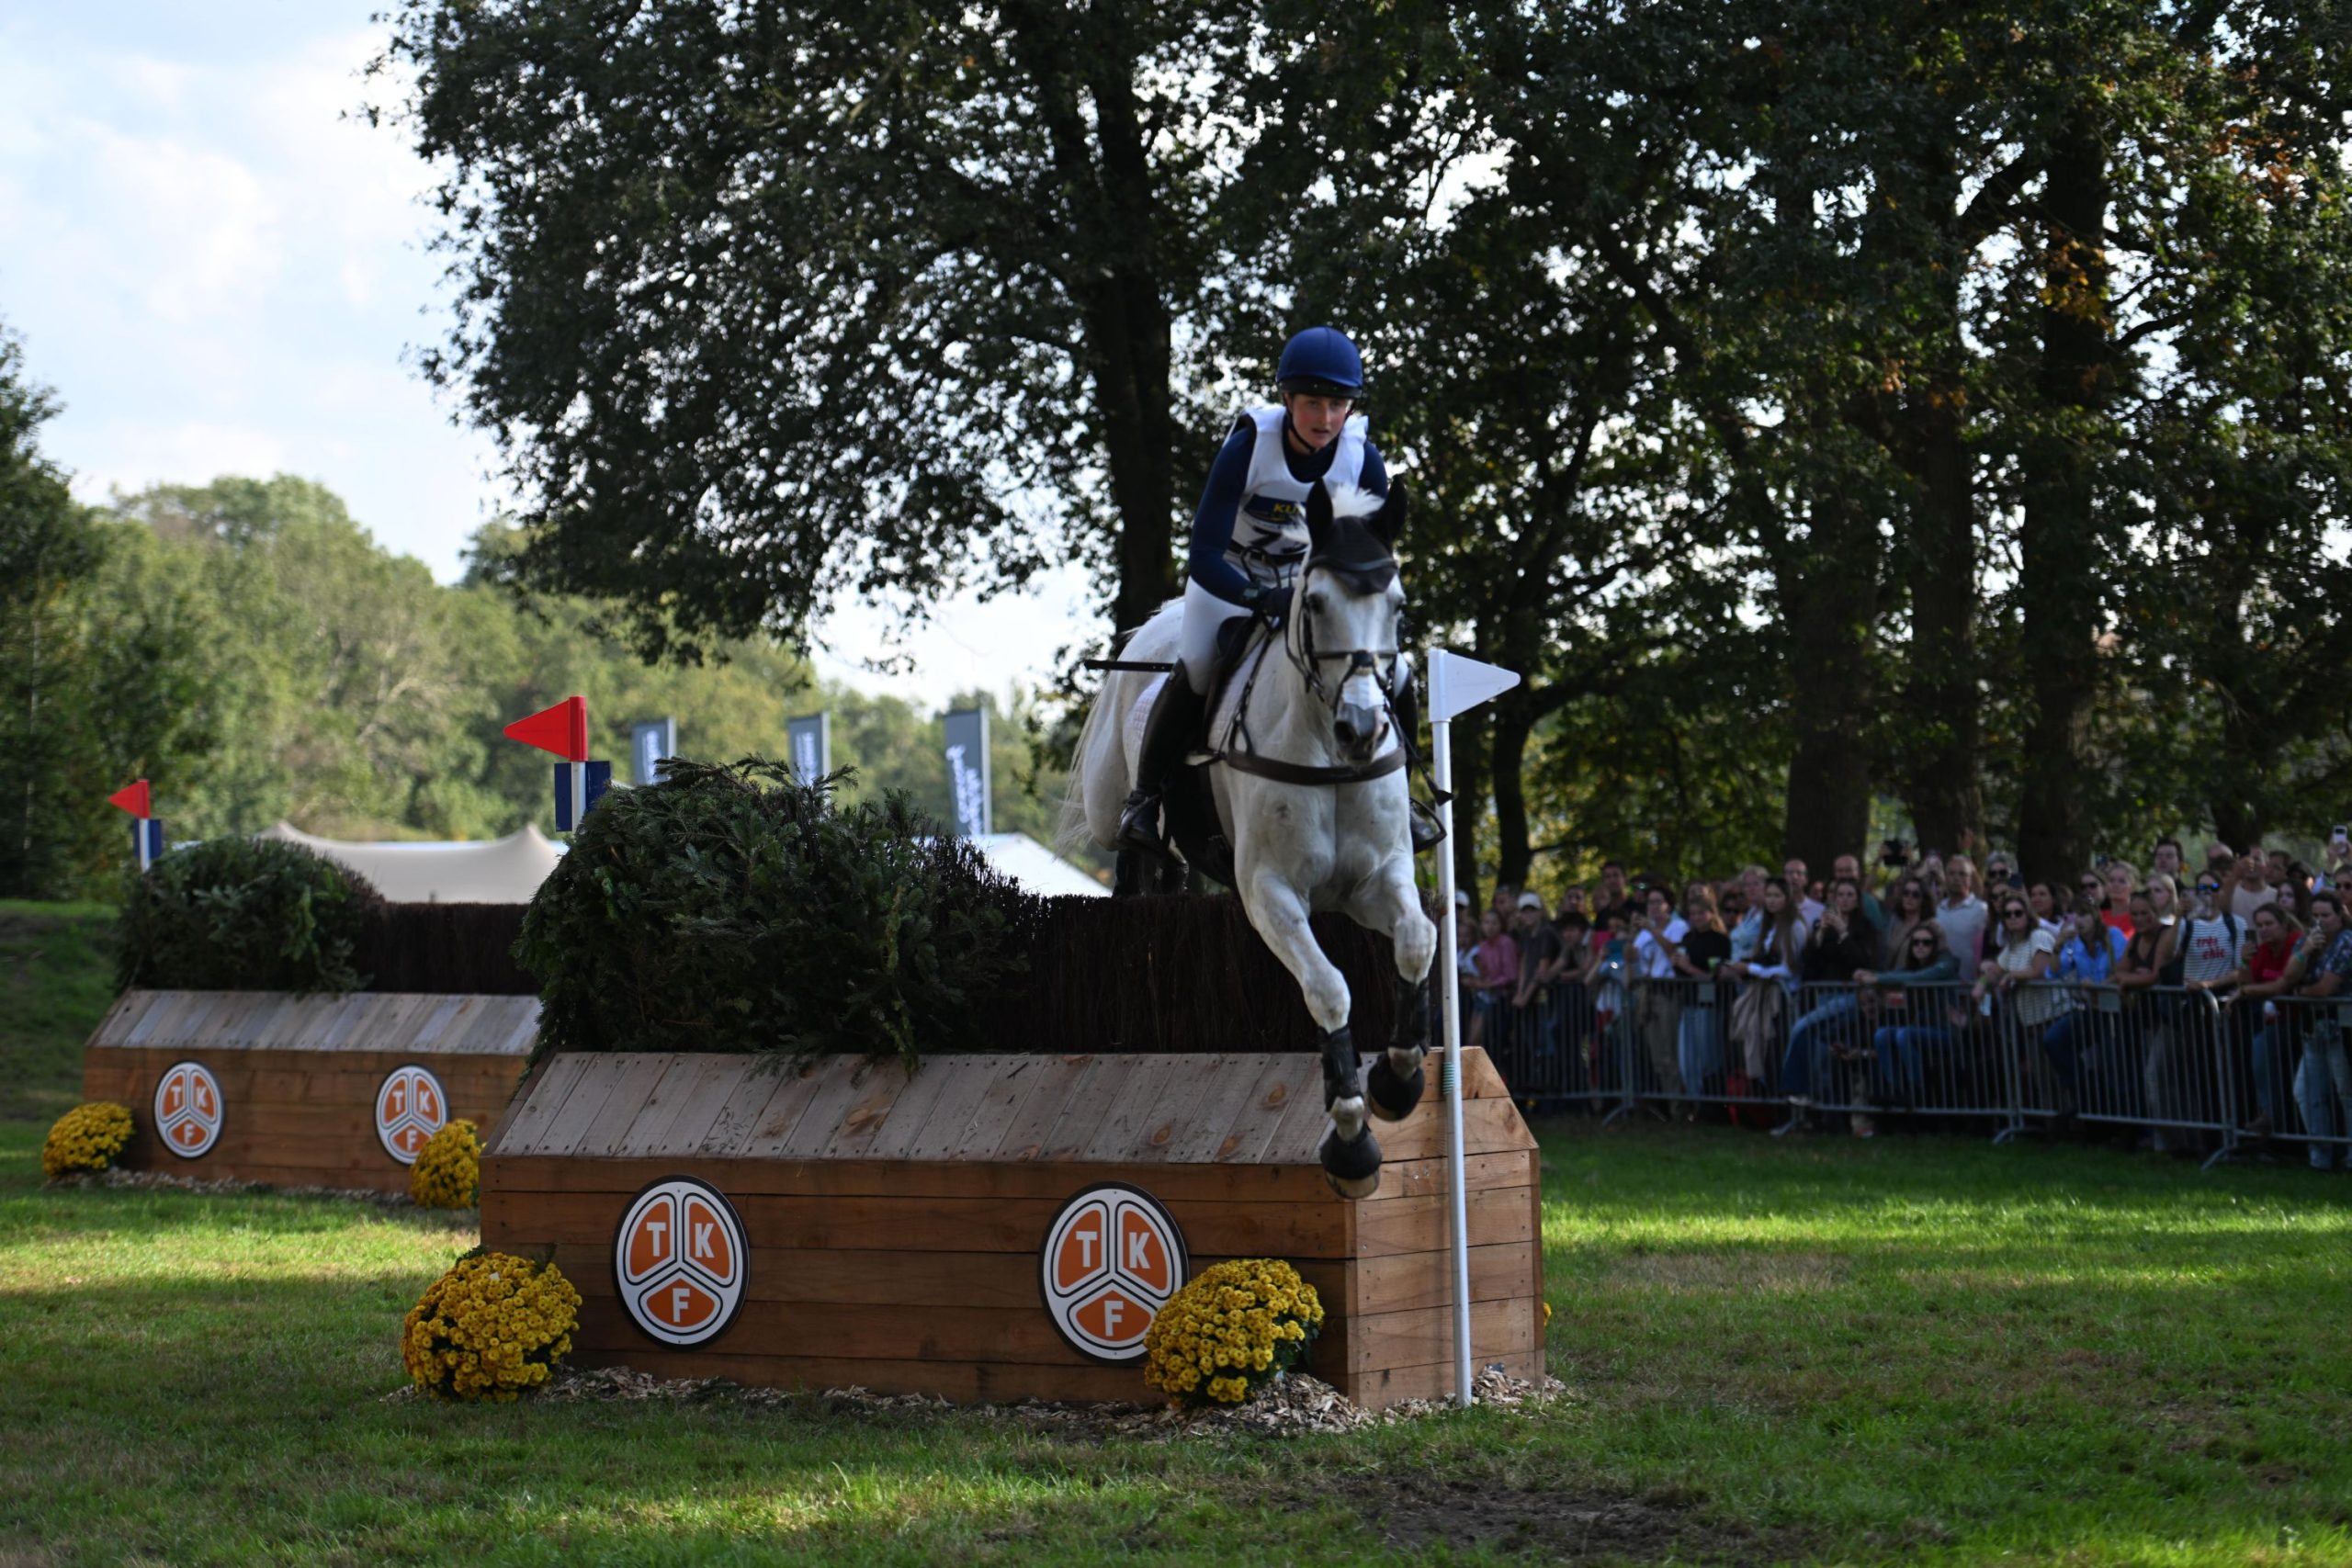
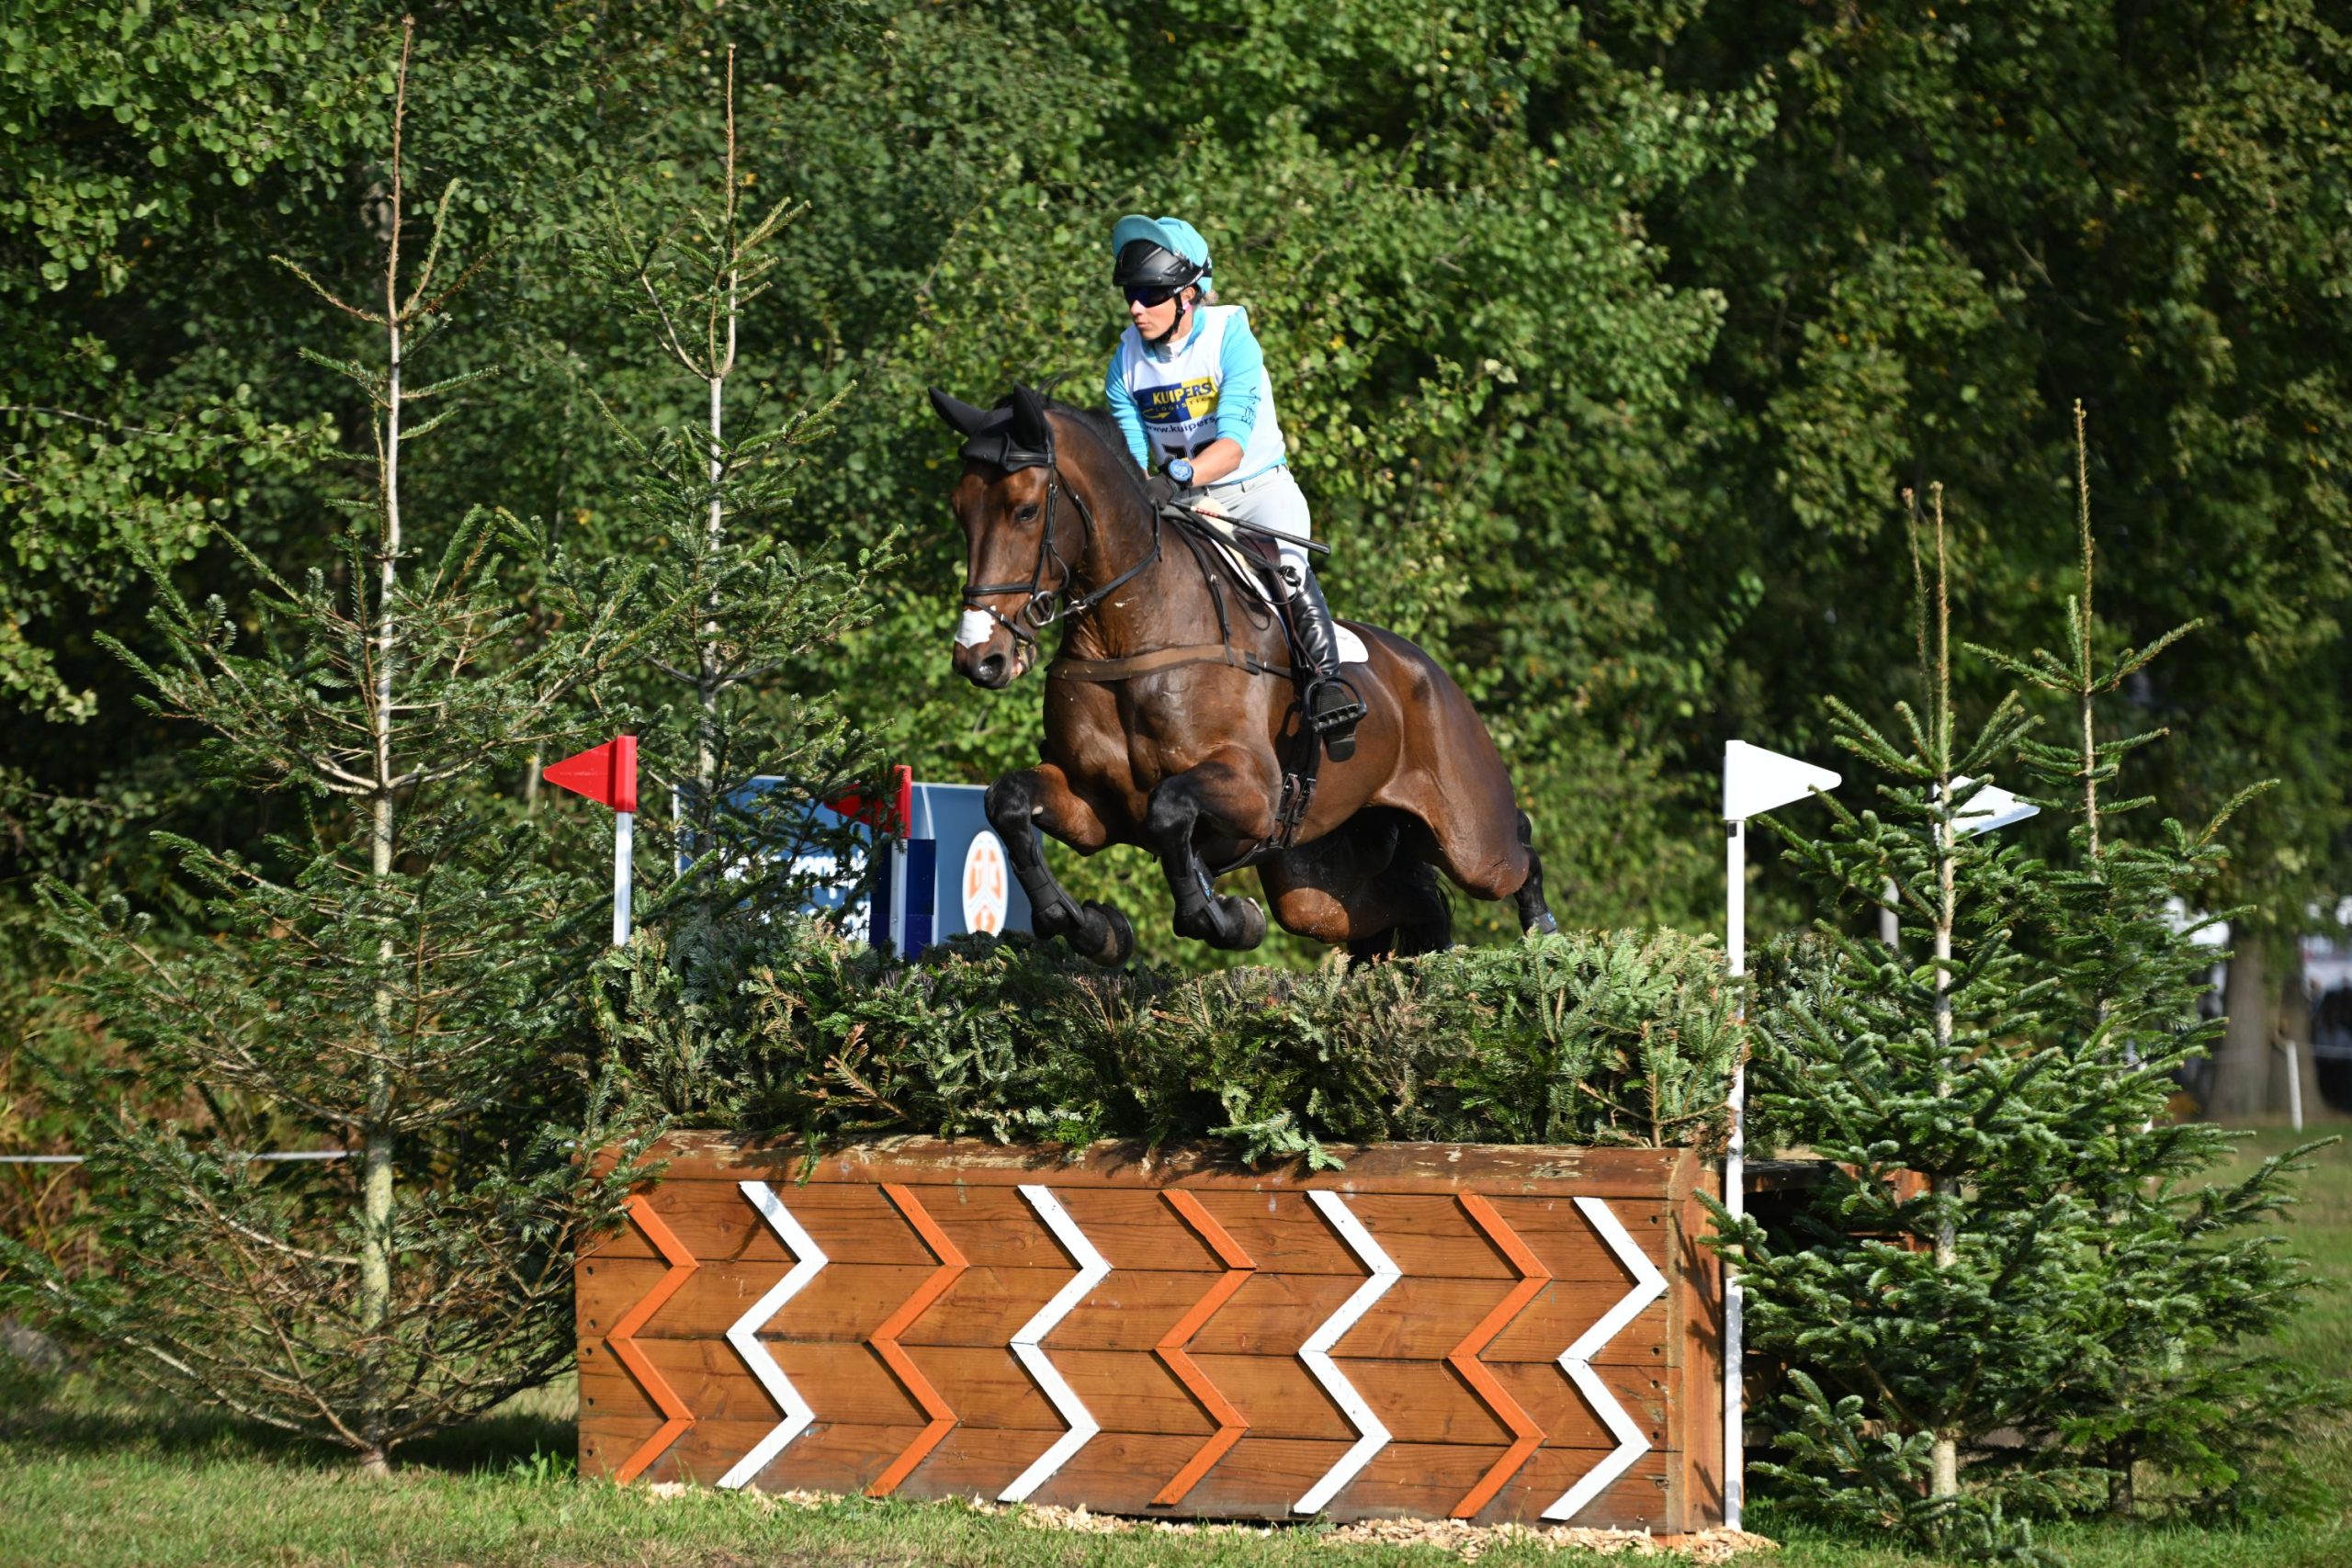
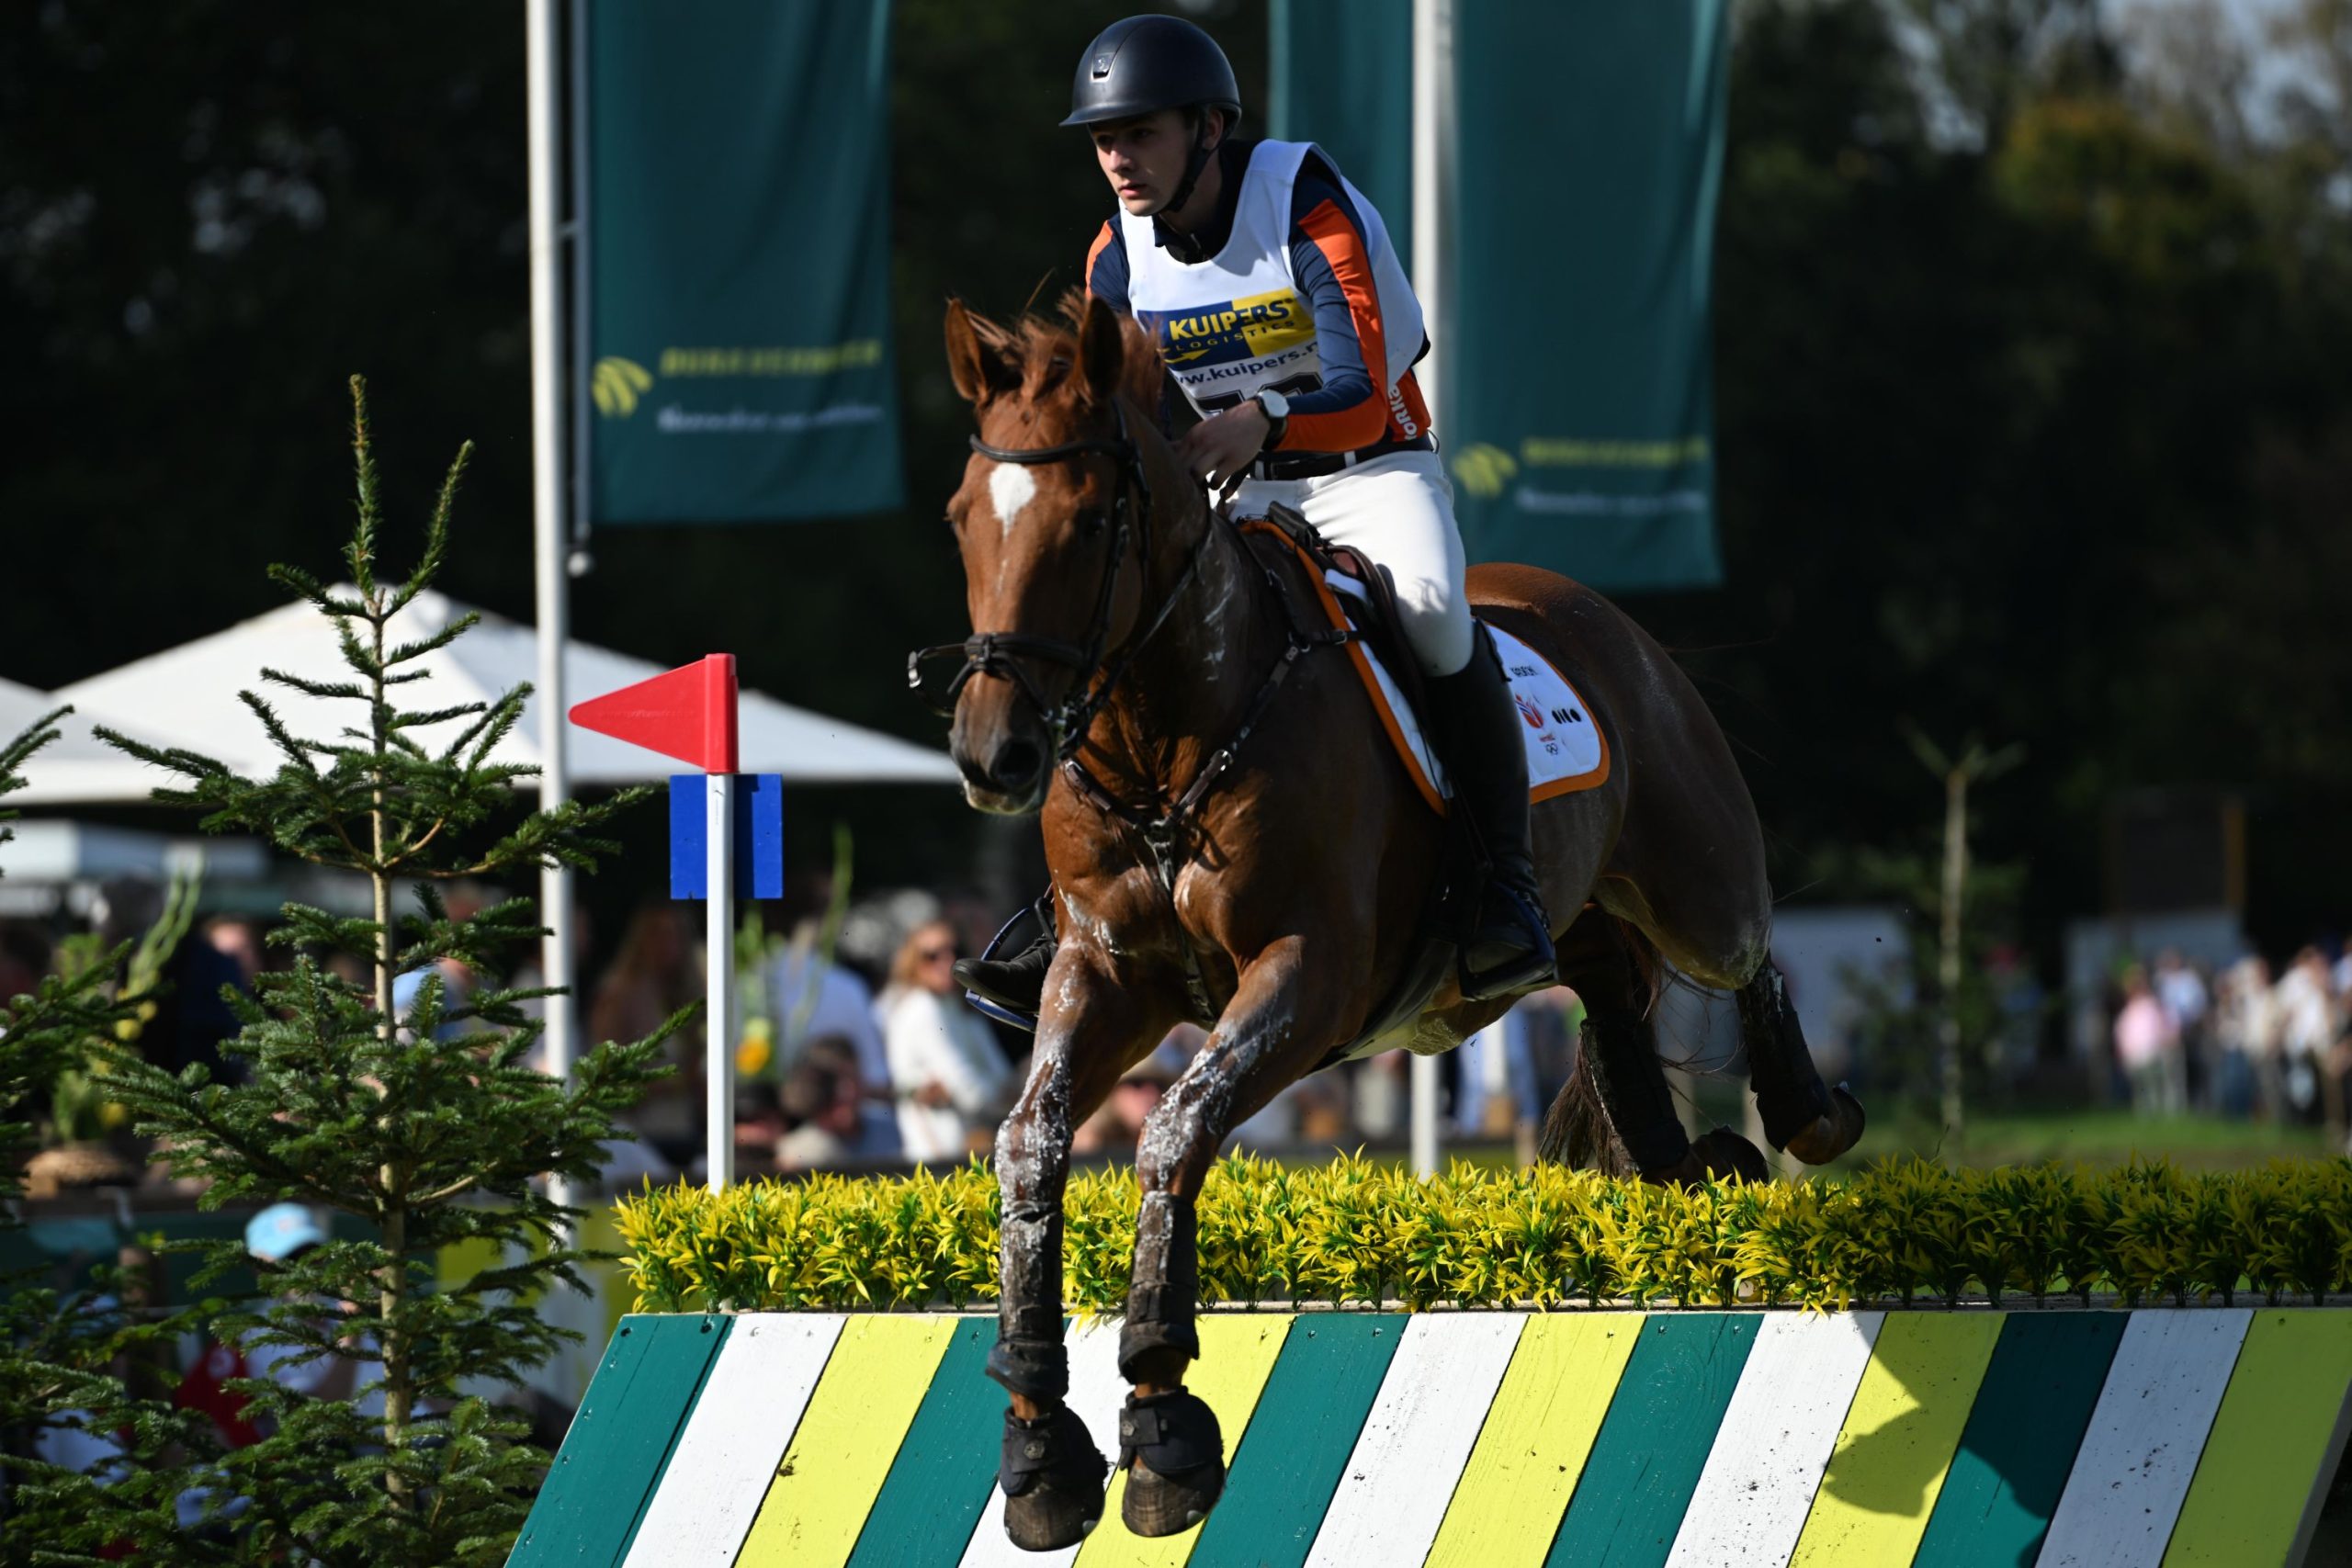
Ook dit jaar mocht ik dankzij Trent weer aanwezig zijn bij de military. Dat was voor mij het perfecte moment om mijn nieuwe Nikon Z8 uit te gaan testen. Deze investering heb ik recentelijk gedaan en is een nieuwe body met 45 megapixel kwaliteit en tot 20 foto’s per seconde kunnen schieten. Mijn oude camera deed er maar 5, dus dat geeft met de paardensport meer mogelijkheden om het perfecte shot te kunnen maken. Ik heb op de Z8 een converter zitten zodat ik mijn oude lenzen kan gebruiken, zodoende was de 70-200mm 2.8 mijn favoriet.
Gecombineerd met het prachtige weer, het heerlijke zonnetje, heb ik weer een aantal fantastische foto’s kunnen maken. En de dag heerlijk bij Trent kunnen afsluiten in hun VIP tent met een bockbiertje en entertainment (Dankjewel Christyn)!

Nieuwe server

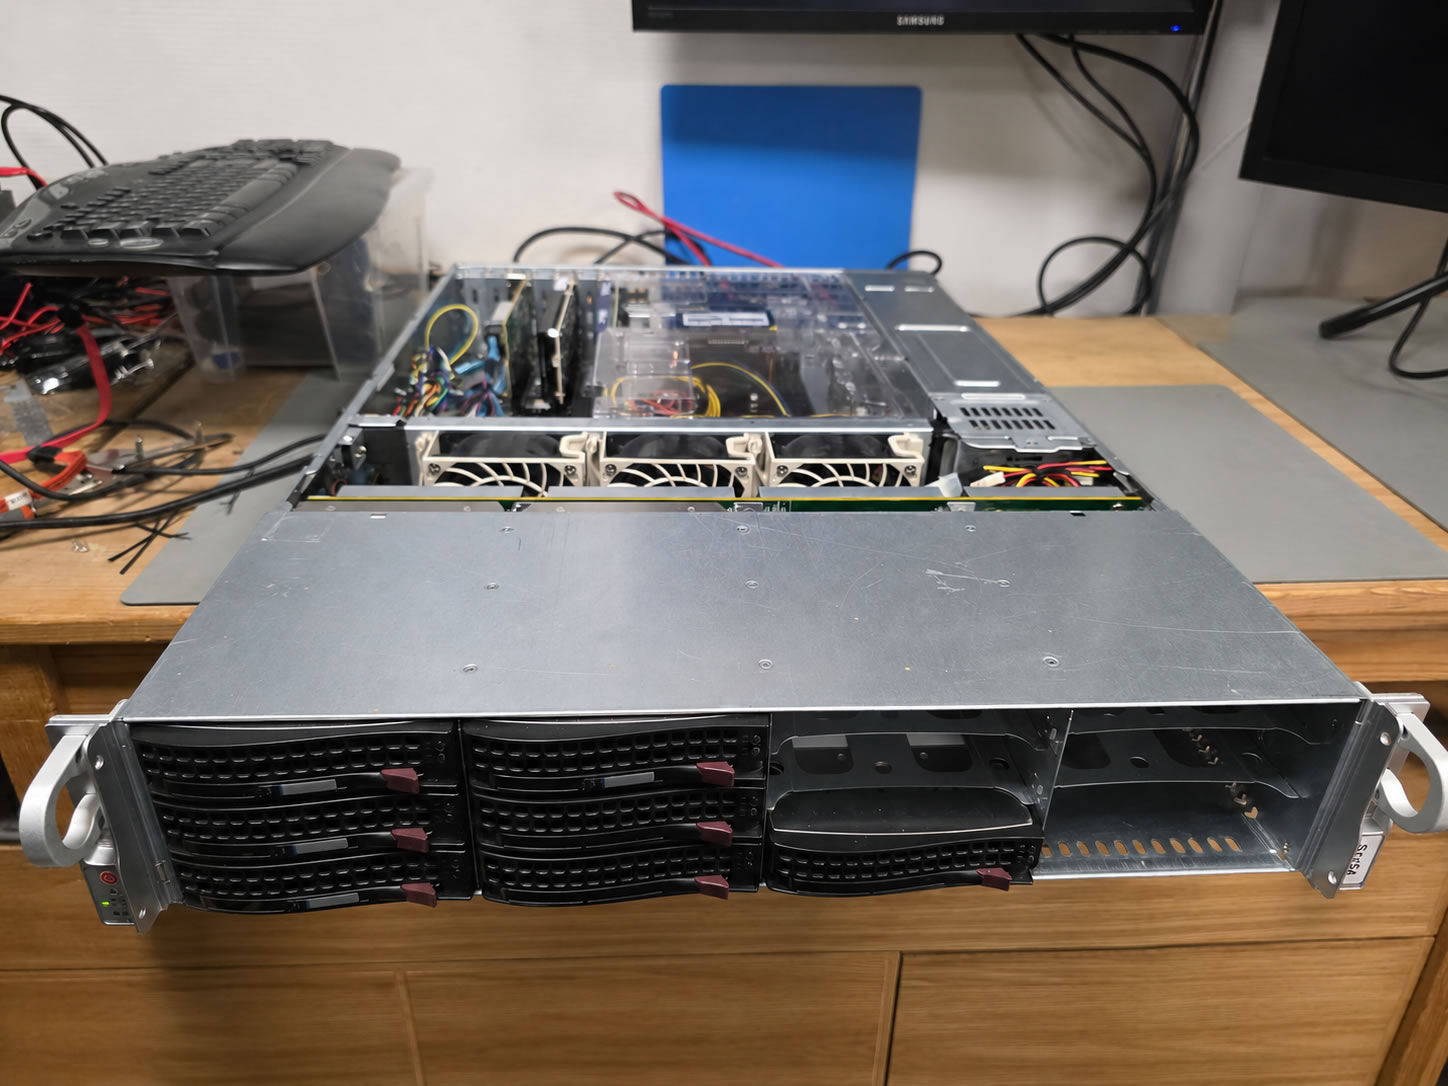
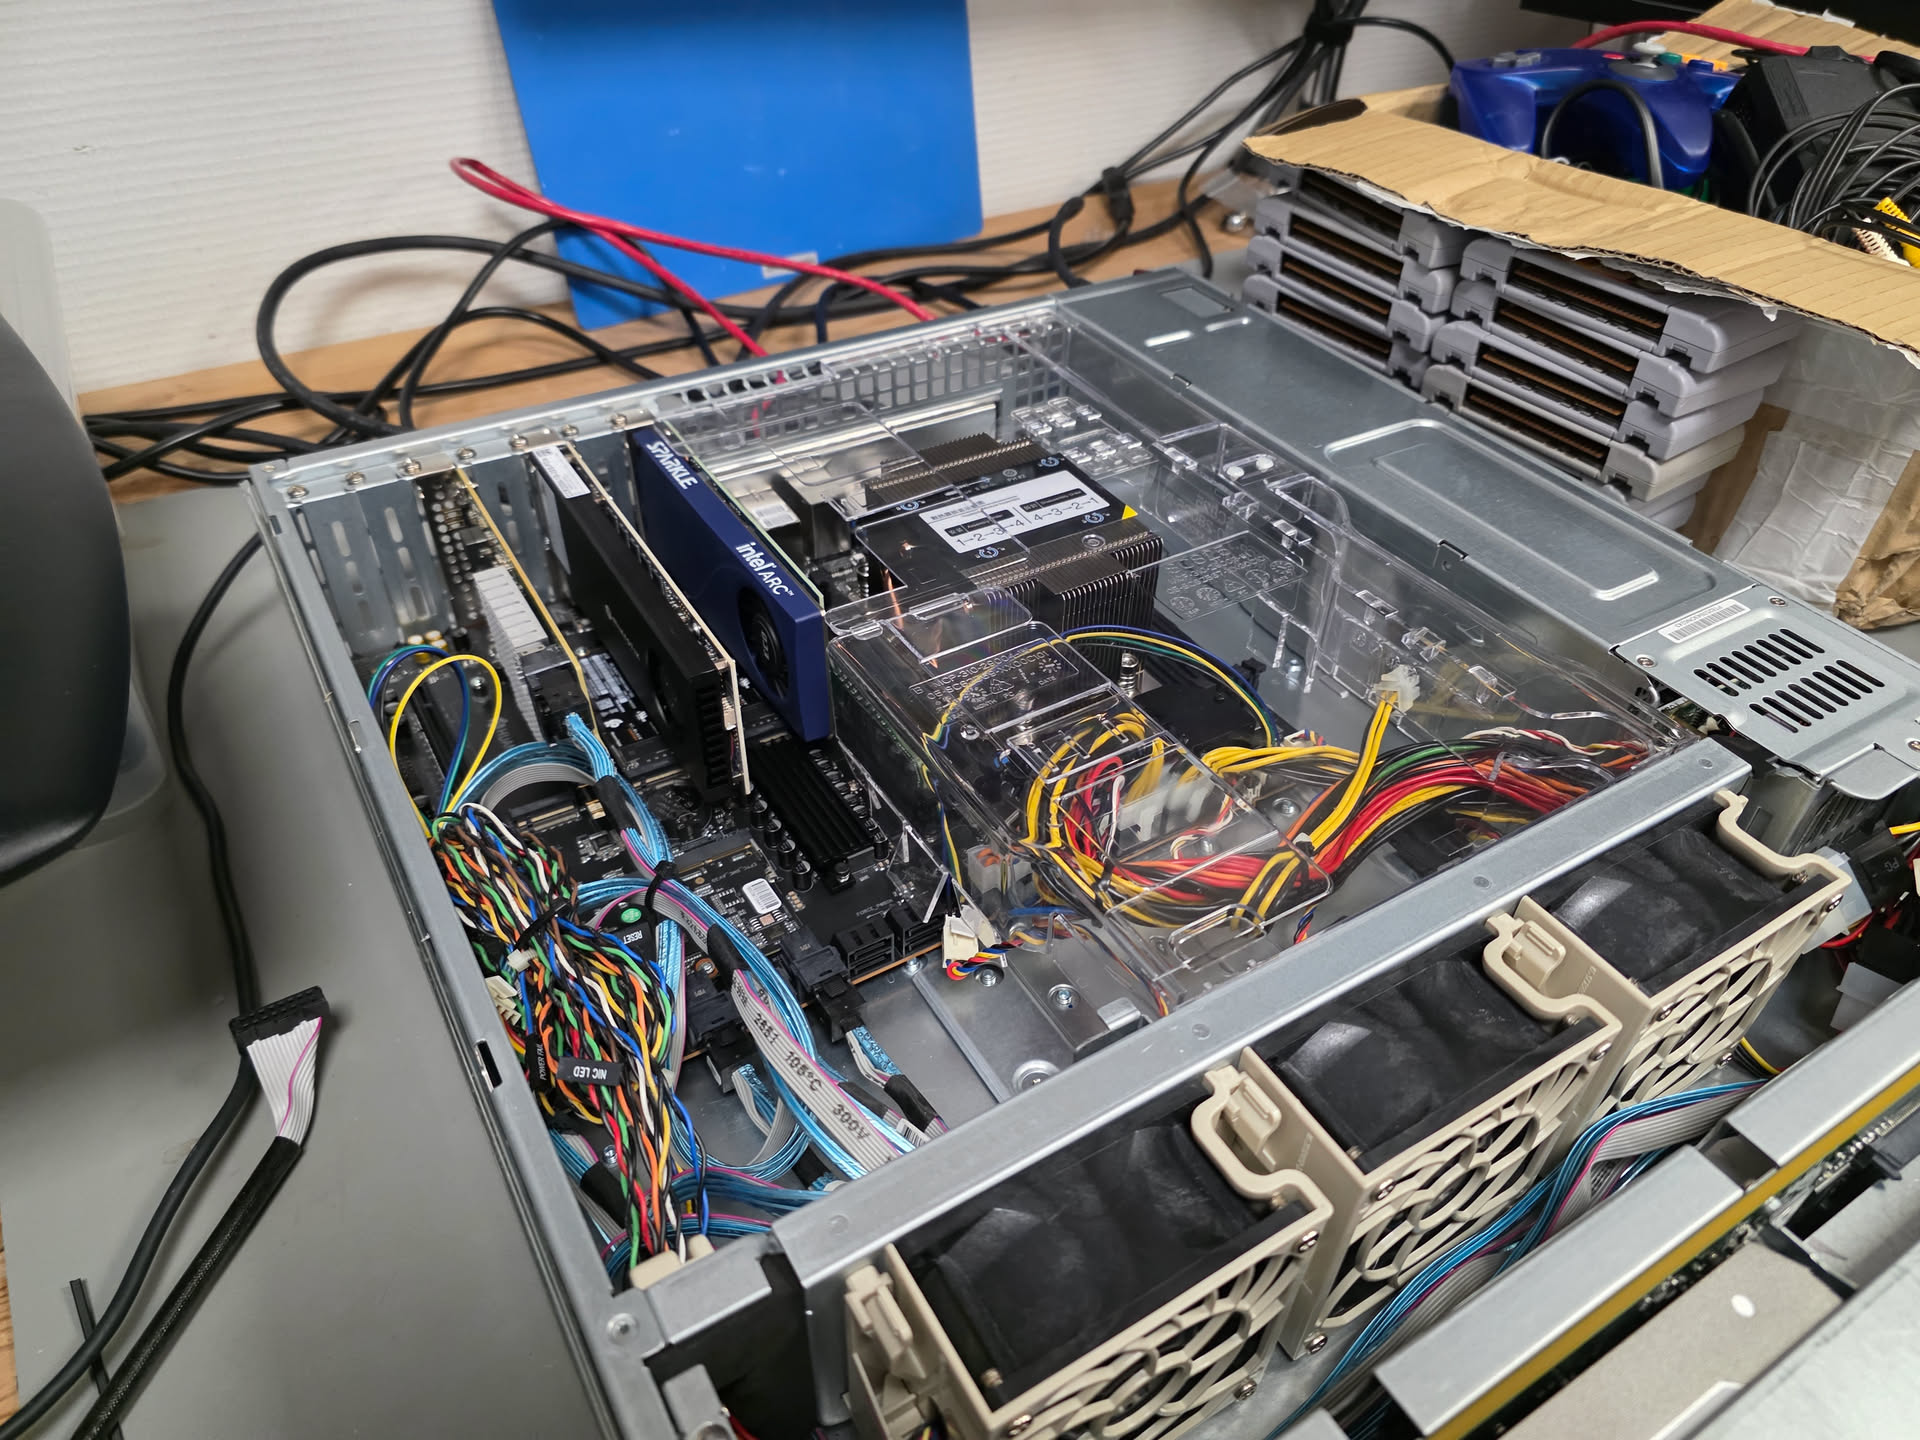
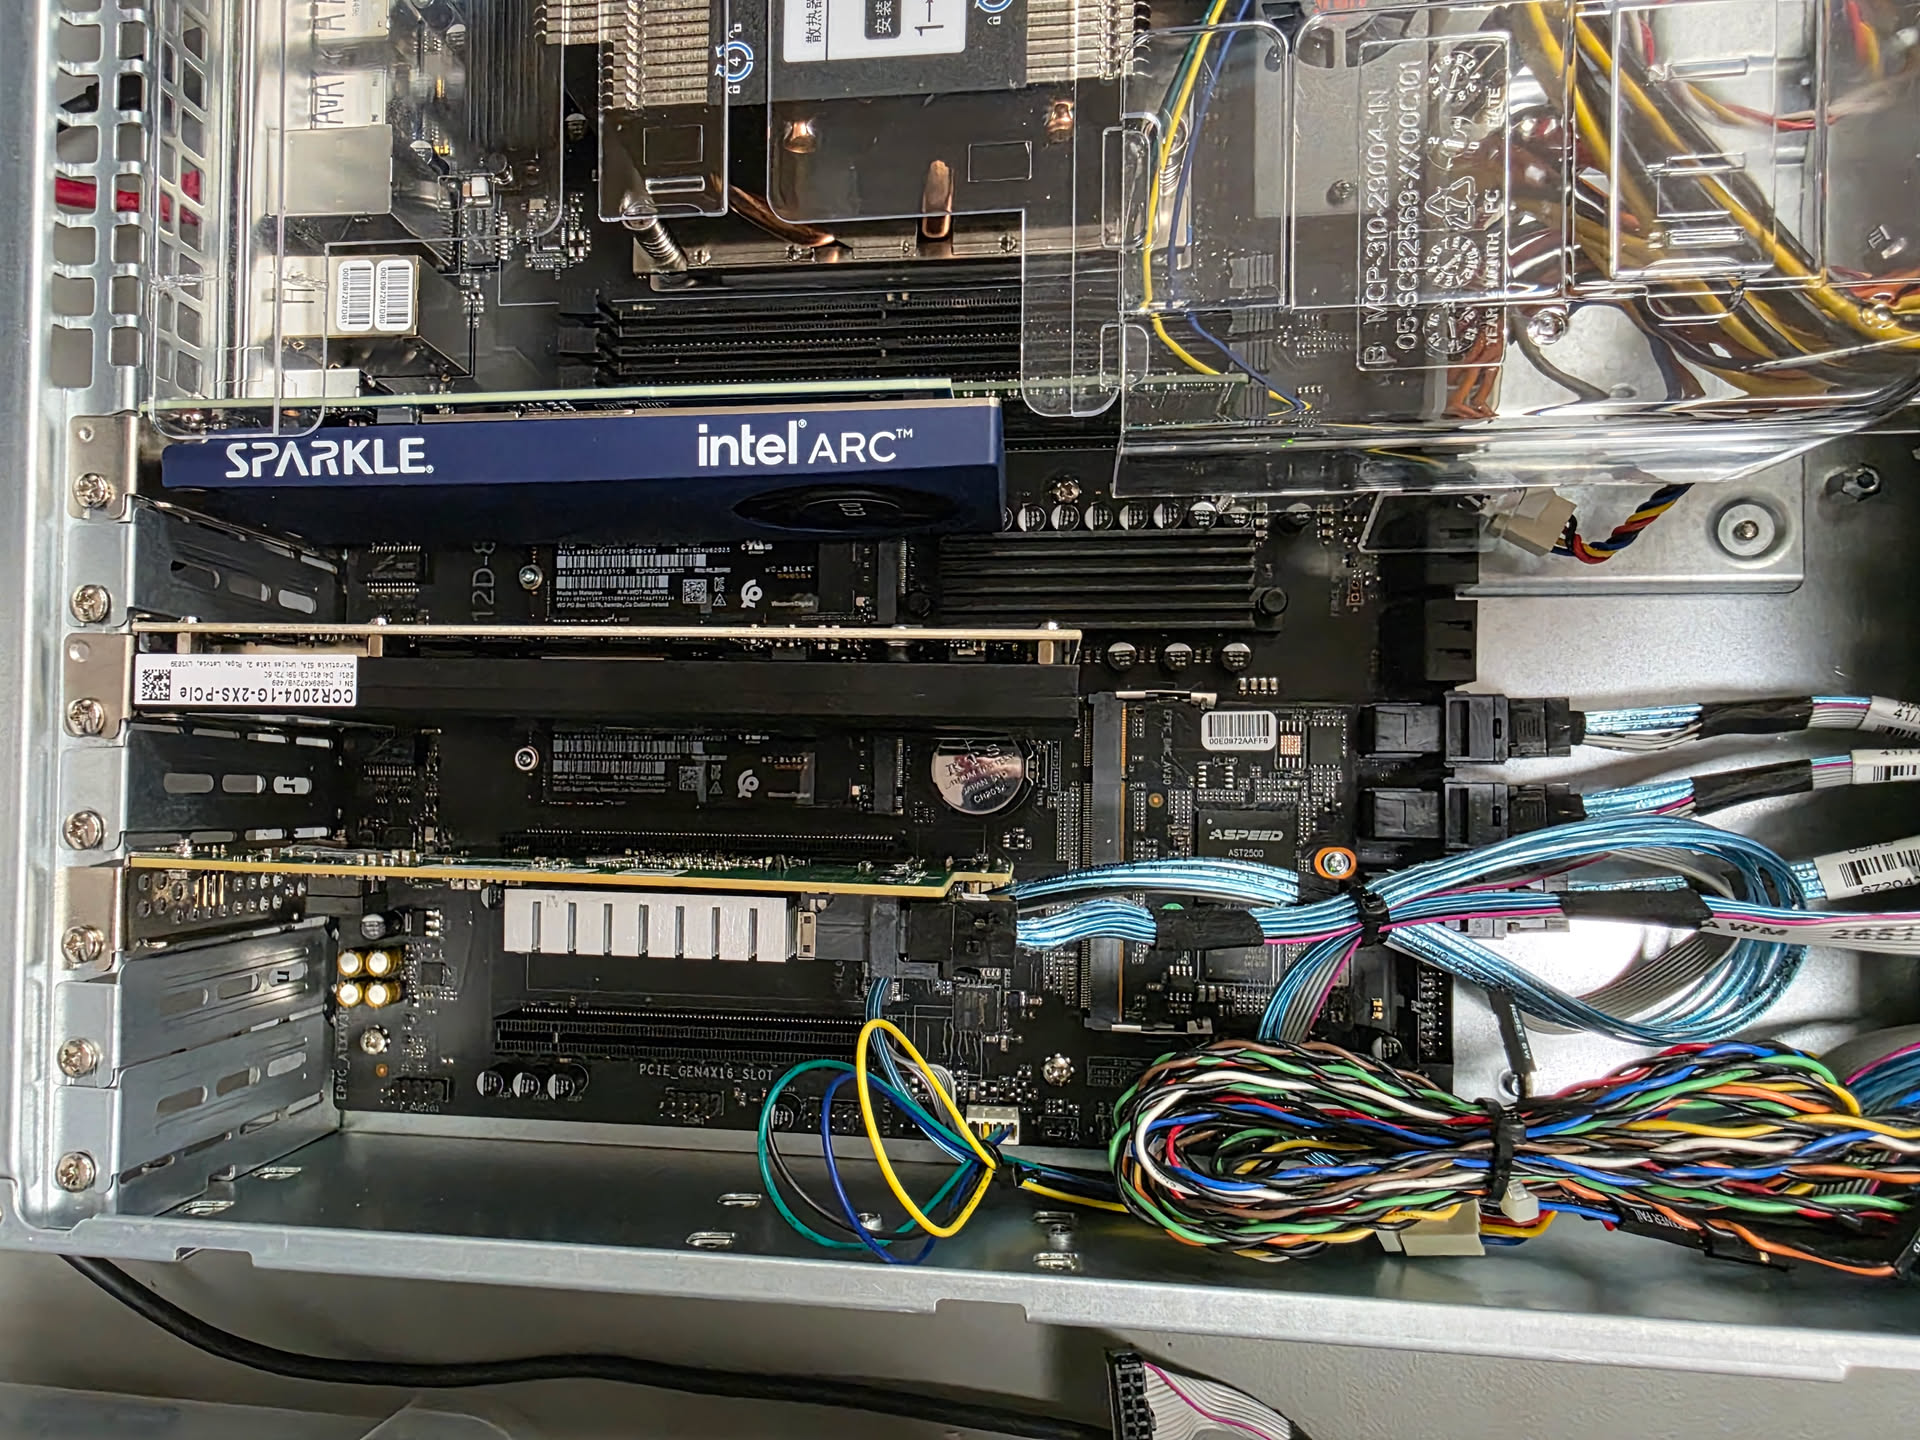
Na 10 jaar op server4 virtueel hebben gedraaid maakt mijn site nu de volgende stap. Enkele maanden geleden heb ik mijn colo server in het datacenter vernieuwd. Wellicht ben je al bekend met de 321 backup regel waarbij: 3 kopieën, op 2 verschillende media, waarvan 1 op een externe locatie. Om die reden had ik al een aantal jaar geleden een mini 1u Atom server in het datacenter opgehangen met 2 x 20TB HDD om de backups van mijn thuisserver weg te kunnen schrijven naar het datacenter over een vpn tunnel. Echter faalde er een HDD en kon ik de backup helemaal opnieuw inrichten. Direct tijd om BTRFS te gaan draaien met RAID1. Anders dan traditionele RAID 1 kan BTRFS meerdere verschillende disks combineren en BTRFS zorgt ervoor dat er altijd 2 kopieën van je data op 2 verschillende disks wordt opgeslagen. Met gevolg dat dat je dan wel dubbel zoveel opslag nodig hebt, en met de 4 bays die de atom had maar net paste. En toen mijn data groeide had ik een 5e disk nodig. Dat was het moment om een nieuw server te kopen want fysiek kon ik geen extra disk kwijt. Ik pakte een 12 bay behuizing en ging opzoek naar een leuk moederbord en cpu. Met mijn bedrijf had ik erg goede ervaring met AMD Epyc series, die zijn zuinig en performen erg goed. Echter de timing voor Ram kon niet beter. Door de Ai gekte is DDR5 niet verkrijgbaar maar ook niet betaalbaar. Dus besloot ik mijn DDR4 ram uit de vorige server mee te nemen. Dat betekende ook dat ik dus oudere generatie AMD en moederbord moet gebruiken. Uiteindelijk kwam ik op de volgende set:

2u 12bay Supermicro behuizing met dubbele voeding
AMD EPYC 7413 24-Core cpu
HUANANZHI H12D-8D met BMC (ipmi)
128GB DDR4 3200mhz ECC REG ram
2x 4TB WD Black SN850X
7x20TB HDD
LSI SAS3008 controller
Intel Arc A310
Mellanox MT27710 (2x25gbit SFP28)

Het moederbord komt van AliExpress weg, dus ik was daar nog een beetje huiverig over. Maar die blijkt goed in elkaar gezet te zijn en ook Bios firmwares worden door die club geleverd. Het was het enige moederbord die betaalbaar was. Ook hier had AI effect, doordat DDR5 niet te betalen is, zijn DDR4 systemen opeens heel populair, en kosten 2e hands systemen opeens erg veel.
Mijn geheugen was compatible, maar doordat de mhz veel lager lag heb ik toch uiteindelijk een nieuw ram reepje gekocht. Die 2x 64gb reepjes, koste bijna netzoveel als de rest van de server.

De bestaande server heb ik als virtuele server aangemaakt met de LSI sas controller in pass through. Kan die lekker zijn eigen disks blijven afhandelen (en dus weer in slaap gooien als er geen backup draait). Proxmox/kvm is de hypervisor. En toen had ik opeens capaciteit over om nog andere vm’s aan te maken. Zodoende is ook het privé AS project begonnen. Dus 1 VM zorgt nu voor de routing. De 10gbit netwerkkaart heb ik erin gestopt omdat ik dan ook direct mee kan doen met de ENS-IX. En daarna heb ik allemaal verschillende vm’s aangemaakt die de infrastructuur doen, zoals 2 x een DNS server, een mail server met mx fallback, een webserver. En zodoende is mijn site overgekomen!

En dan vraag je af waarom zit er een Intel Arc kaart in je server? Ik wil nog iets gaan doen met transcoden van video’s. En Intel gpu’s zijn daar het beste in. Dus die had ik alvast in de server geplaatst. Het project moet nog gaan beginnen.

Nieuwe Thema

Na 18 jaar is de Primepress thema uit 2008 vervangen door een nieuwe. En deze thema is geen standaard thema. Ik was nogal gecharmeerd van de oude thema en ik wou eigenlijk een vergelijkbare thema opzetten die alleen beetje anno nu is en vooral mobile friendly is. Dus samen met Chatgpt heb ik deze vraag uitgezet en voila hij spuugde een thema uit. Na een aantal foutjes gefixt te hebben stond het nieuwe thema online!

En opnieuw heb ik ervoor gekozen om weer een willekeurige foto of screenshot als header te gebruiken. De set van 20 oude afbeeldingen heb ik vernieuwd met 20 nieuwe. Alle zorgvuldig door mij gemaakt, of zorgvuldig tijdens het gamen uitgezocht. Een aantal zijn zelfs geüpdatet van de originele set naar een hogere resolutie.

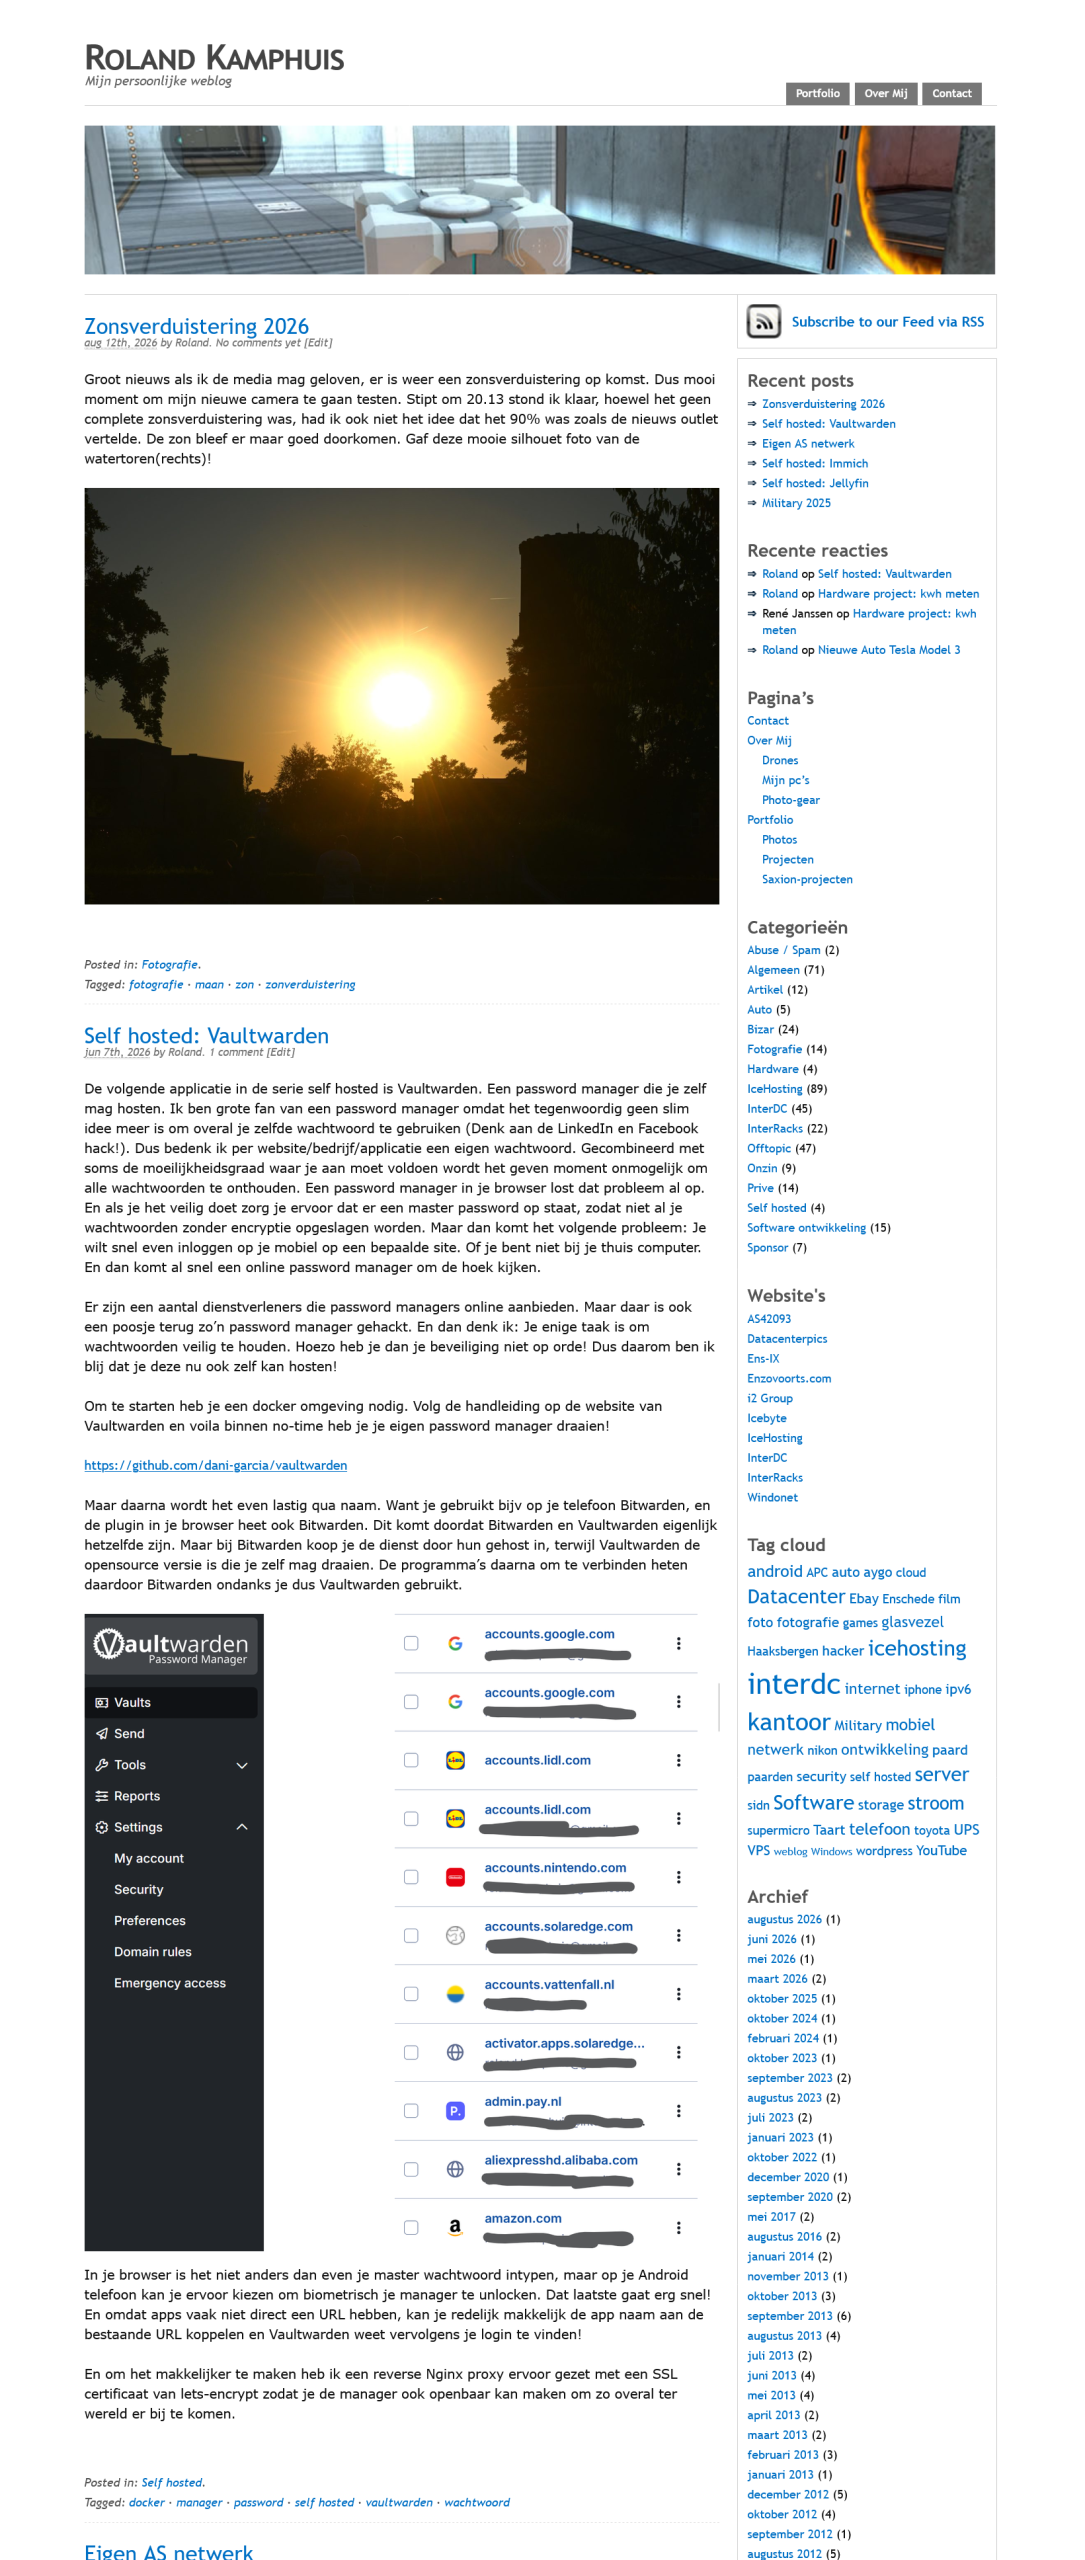
Als aandenken aan de oude thema hier een screenshot.

Zonsverduistering 2026

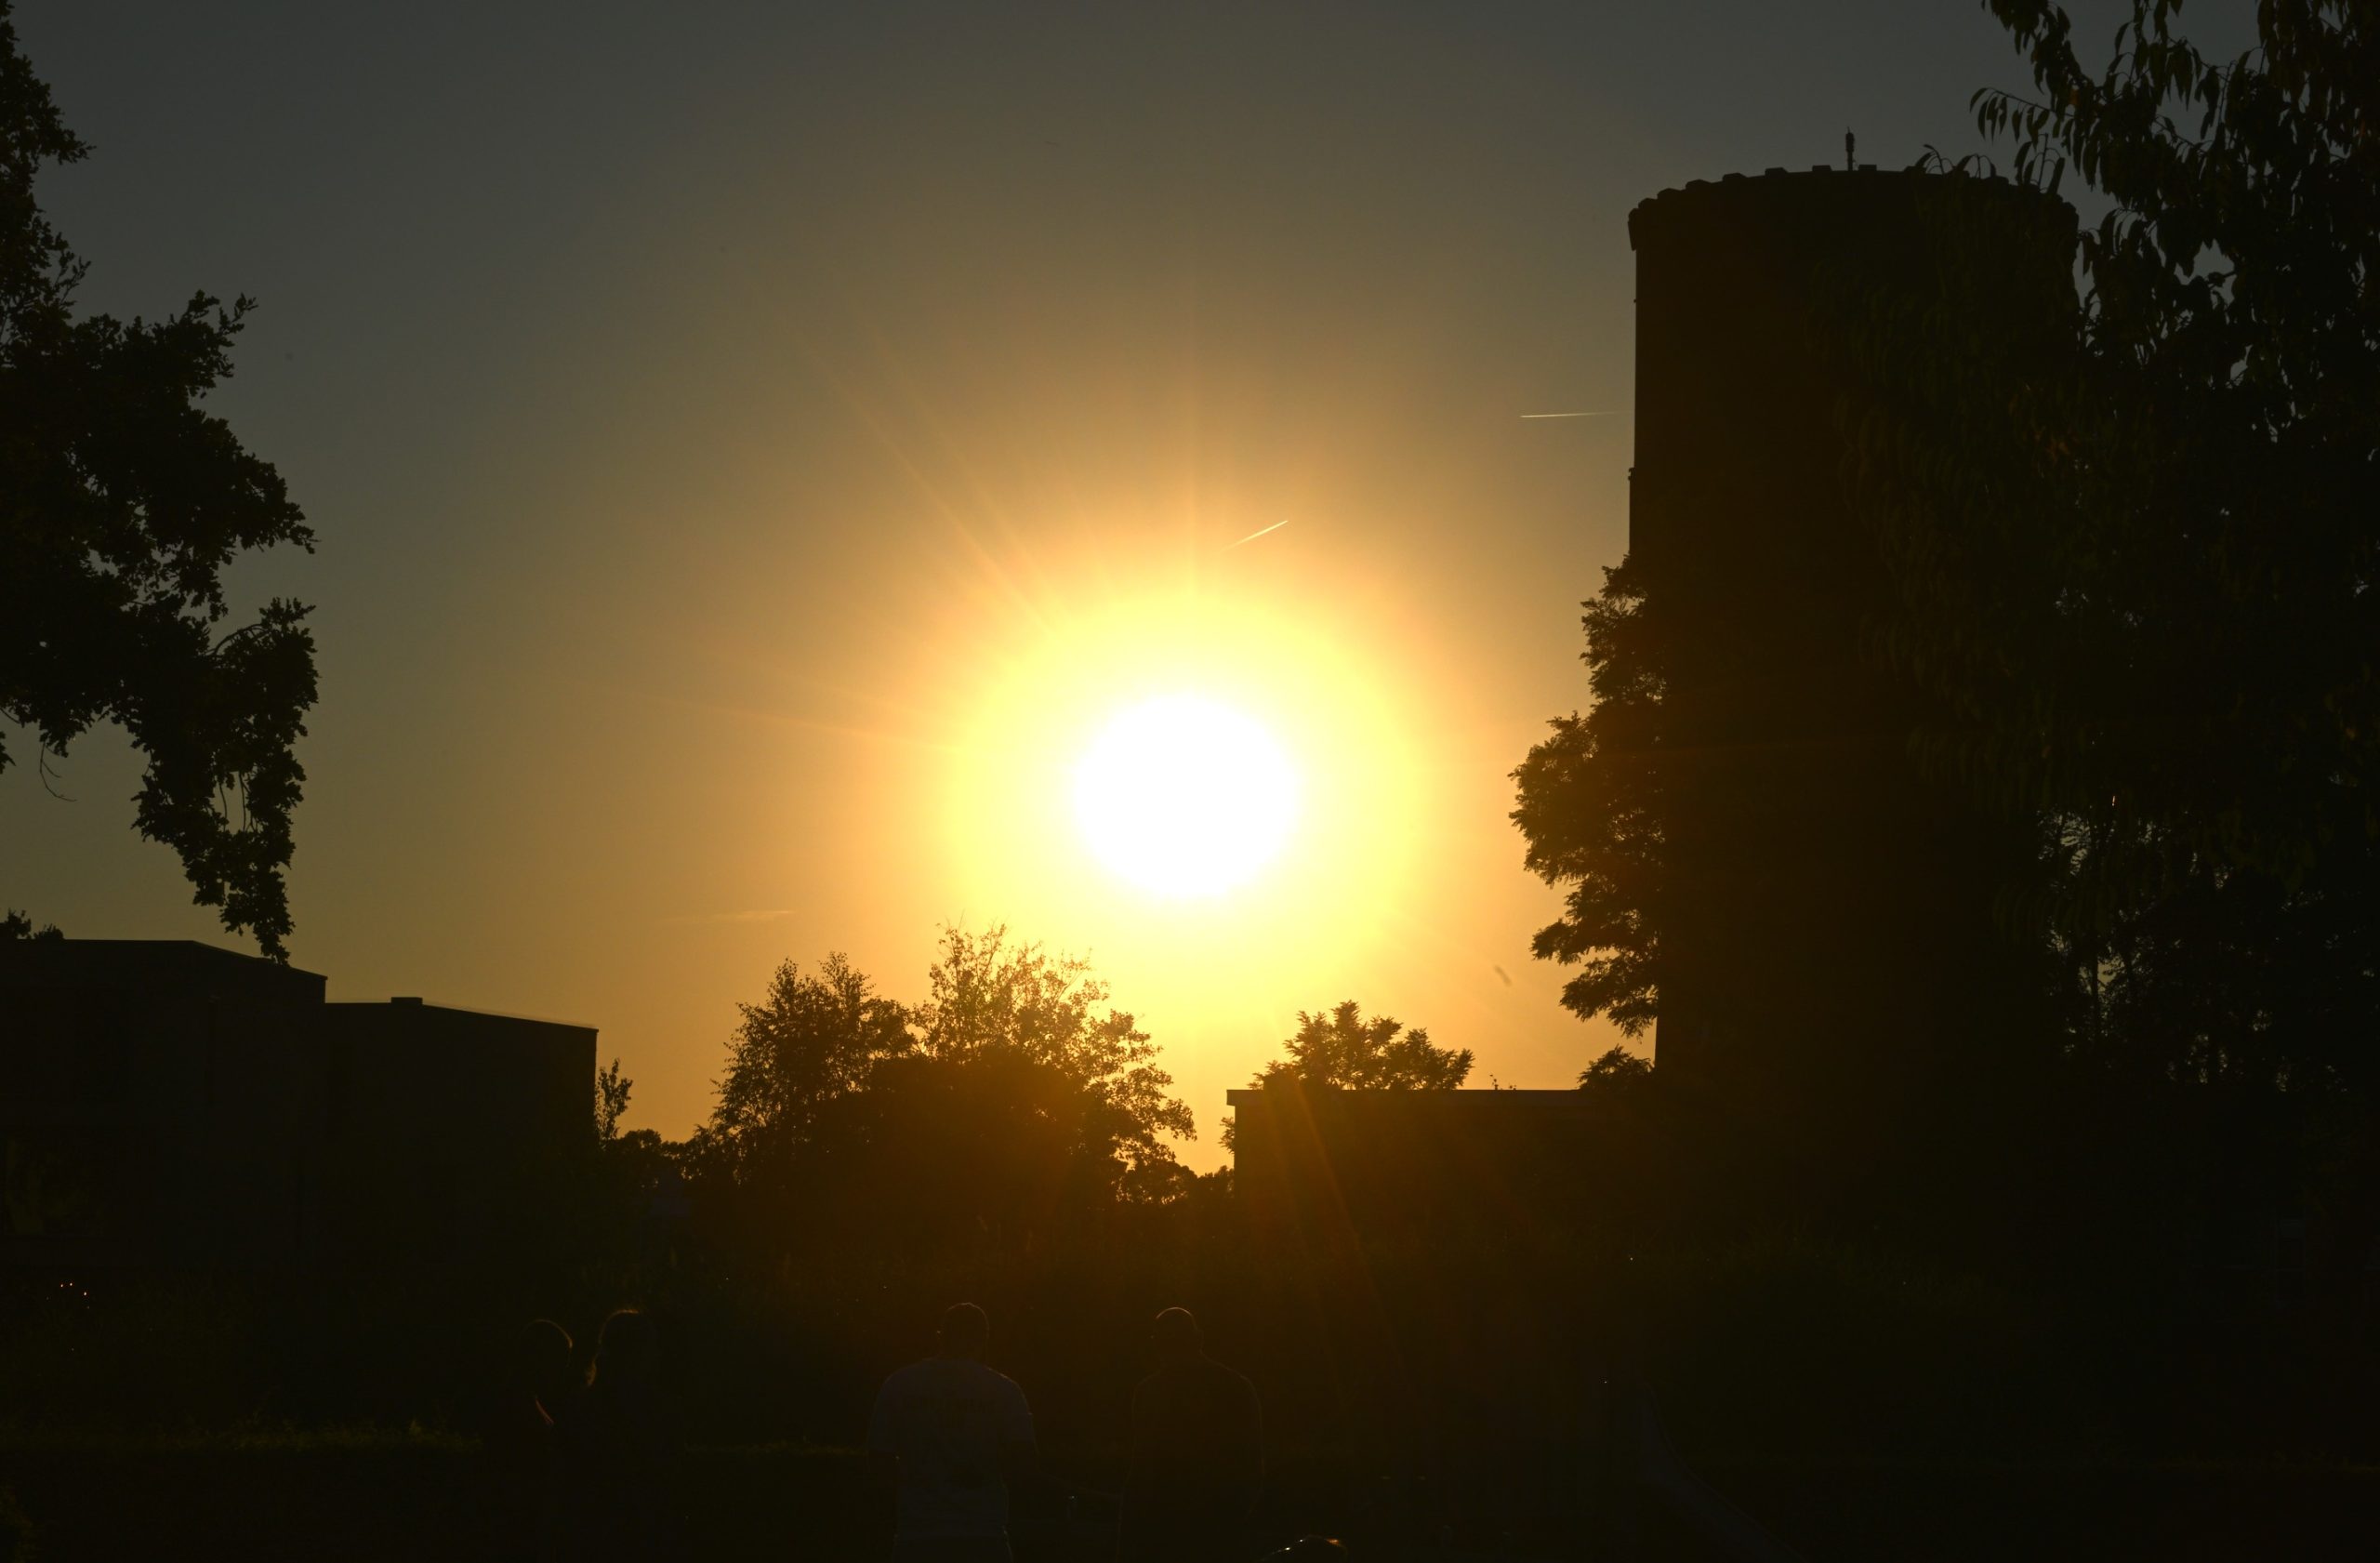
Groot nieuws als ik de media mag geloven, er is weer een zonsverduistering op komst. Dus mooi moment om mijn nieuwe camera te gaan testen. Stipt om 20.13 stond ik klaar, hoewel het geen complete zonsverduistering was, had ik ook niet het idee dat het 90% was zoals de nieuws outlet vertelde. De zon bleef er maar goed doorkomen. Gaf deze mooie silhouet foto van de watertoren(rechts)!

Self hosted: Vaultwarden

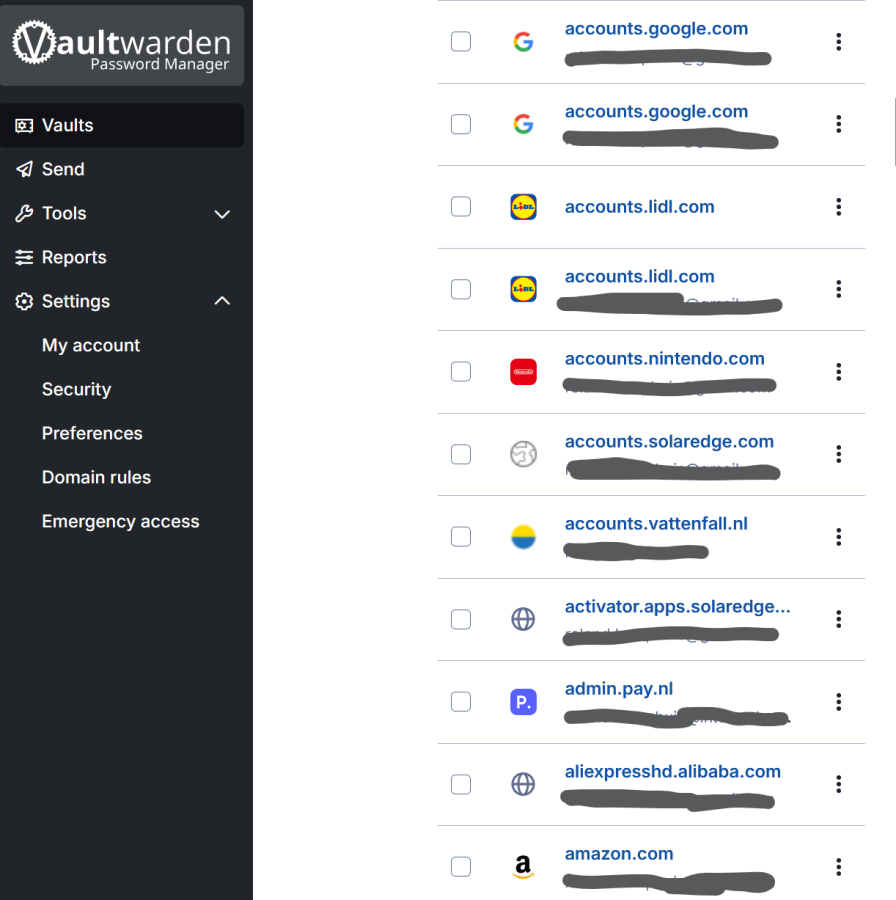
De volgende applicatie in de serie self hosted is Vaultwarden. Een password manager die je zelf mag hosten. Ik ben grote fan van een password manager omdat het tegenwoordig geen slim idee meer is om overal je zelfde wachtwoord te gebruiken (Denk aan de LinkedIn en Facebook hack!). Dus bedenk ik per website/bedrijf/applicatie een eigen wachtwoord. Gecombineerd met soms de moeilijkheidsgraad waar je aan moet voldoen wordt het geven moment onmogelijk om alle wachtwoorden te onthouden. Een password manager in je browser lost dat probleem al op. En als je het veilig doet zorg je ervoor dat er een master password op staat, zodat niet al je wachtwoorden zonder encryptie opgeslagen worden. Maar dan komt het volgende probleem: Je wilt snel even inloggen op je mobiel op een bepaalde site. Of je bent niet bij je thuis computer. En dan komt al snel een online password manager om de hoek kijken.

Er zijn een aantal dienstverleners die password managers online aanbieden. Maar daar is ook een poosje terug zo’n password manager gehackt. En dan denk ik: Je enige taak is om wachtwoorden veilig te houden. Hoezo heb je dan je beveiliging niet op orde! Dus daarom ben ik blij dat je deze nu ook zelf kan hosten!

Om te starten heb je een docker omgeving nodig. Volg de handleiding op de website van Vaultwarden en voila binnen no-time heb je je eigen password manager draaien!

https://github.com/dani-garcia/vaultwarden

Maar daarna wordt het even lastig qua naam. Want je gebruikt bijv op je telefoon Bitwarden, en de plugin in je browser heet ook Bitwarden. Dit komt doordat Bitwarden en Vaultwarden eigenlijk hetzelfde zijn. Maar bij Bitwarden koop je de dienst door hun gehost in, terwijl Vaultwarden de opensource versie is die je zelf mag draaien. De programma’s daarna om te verbinden heten daardoor Bitwarden ondanks je dus Vaultwarden gebruikt.

In je browser is het niet anders dan even je master wachtwoord intypen, maar op je Android telefoon kan je ervoor kiezen om biometrisch je manager te unlocken. Dat laatste gaat erg snel! En omdat apps vaak niet direct een URL hebben, kan je redelijk makkelijk de app naam aan de bestaande URL koppelen en Vaultwarden weet vervolgens je login te vinden!

En om het makkelijker te maken heb ik een reverse Nginx proxy ervoor gezet met een SSL certificaat van lets-encrypt zodat je de manager ook openbaar kan maken om zo overal ter wereld er bij te komen.

Eigen AS netwerk

Vorig jaar was ik bij de NNOG meetup, en een van de dingen die me opviel is dat er een aantal engineers een private AS netwerk hadden. Iedere provider op het internet heeft uniek AS nummer( Autonomous system). Hiermee kan er onderscheid gemaakt worden tussen bijv het KPN netwerk en het Vodafone netwerk. Mijn onderneming heeft ook sinds 2006 een eigen AS, waarmee je onafhankelijk het internet kan regelen binnen. Een van de dingen die je nodig hebt om dat functioneel te krijgen is een hele dure router. Die krengen gingen vroeger voor minimaal 50k, en nog steeds; in mijn onderneming gebruiken we hardware routers van Arista met 32x100gbit poorten. Echter zijn er ook goedkopere oplossingen op de markt gekomen die voor kleine netwerken zeer betaalbaar zijn. Zo kan je voor nog geen 500 euro ook een mikrotik kopen die in de praktijk hetzelfde zou moeten kunnen, maar dan op 1 of 10gbit snelheid met een halve BGP tabel. Met een iets hoger budget kan je zelfs full BGP draaien bij Mikrotik. Ook de software routers zijn een optie geworden doordat de reguliere computers ook een stuk sneller zijn geworden. Dus vandaar dat ik nu ook een prive AS nummer heb aangevraagd om zo te kunnen gaan spelen en experimenteren met alternatieve hardware zonder daarmee de productie omgeving in mijn onderneming te hoeven verstoren.

Ripe NCC is de instantie in Europa/Rusland die in deze regio de ip adressen en AS nummers uitdeelt. Officieel moet je Ripe lid worden of een Ripe sponsor zien te vinden. Gelukkig is mijn onderneming sinds 2009 al Ripe lir en kon ik via die weg een een PI block en PI AS aanvragen. Belangrijk is dat je deze als PI aanvraagt. PI staat namelijk voor Provider independent en wordt op de naam van de eindklant uitgegeven. Dat betekend ook dat ik zowel het ipv6 block als AS nummer kan meeverhuizen als ik naar een andere Ripe sponsor wil. Ofwel de resources zijn altijd van mij. Nadeel van PI is dat je geen onderverdeling mag doen van je ip blokken.
De PI optie kost 75 euro per jaar per resource (AS, ipv4, ipv6), afrekenbaar via je Ripe sponsor plus eventuele tussenpartij doorschuifkosten. Mijn bedrijf biedt deze optie ook aan mocht je interesse hebben.
De optie voor PI bestaat ook voor ipv4, helaas zijn die blocken heel schaars geworden omdat Ripe in 2012 gestopt is deze uit te geven. Mocht je een PI block weten te bemachtigen of over te nemen dan is dat de beste optie!
De enige andere manier om aan ipv4 te komen is om deze te huren in PA vorm (niet je eigendom) of zelf Ripe deelnemer te worden en een ip PA block te kopen van een andere partij. Een ipv4 /24 block gaat op dit moment voor rond de 6500 euro. En daarbij komt ook nog dus de jaarlijkse Ripe lidmaatschap kosten van 2000 euro.
Ik heb voor mijn private netwerk een ip block van mijn bedrijf gehuurd. En opnieuw kan je dit ook bij mijn bedrijf bestellen bij interesse.

Mijn netwerk:

AS198092 Kamphuis
2001:678:1264::/48
62.129.148.0/24

Sinds een paar maanden heb ik mijn privé server geupgrade van een Atom D525 naar een EPYC 7413 en heb ik opeens veel meer performance tot mijn beschikking. (Passmark 411 VS 36.966 ofwel 8900% sneller).
Meer info over deze server upgrade binnenkort, netzoals hoe het uitrollen van het netwerk gaat.

Self hosted: Immich

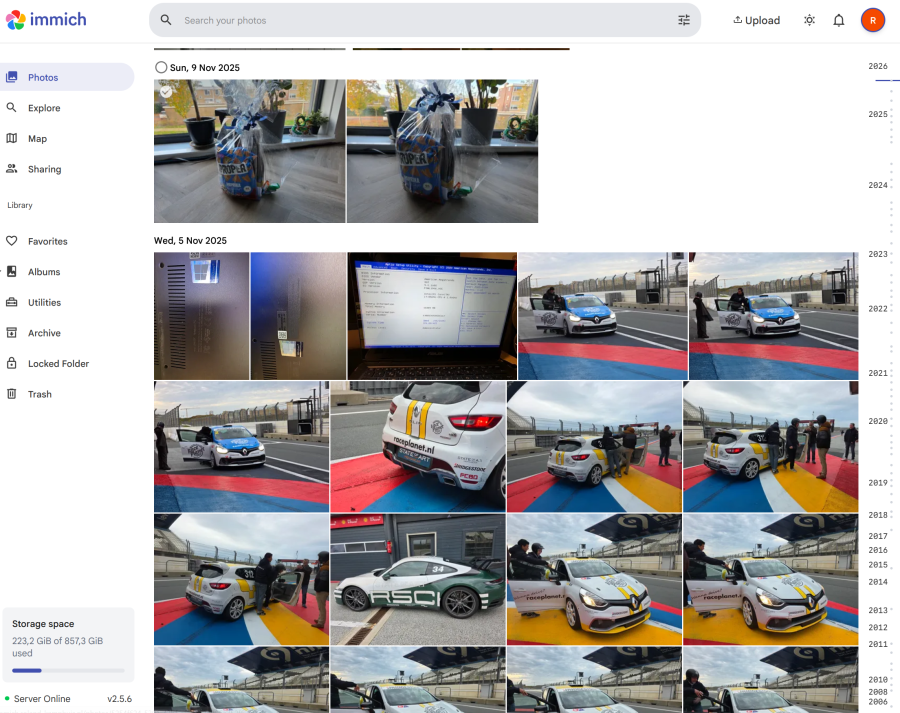
Volgens mij heeft iedereen wel een vorm van cloud opslag. Ik gebruik het voornamelijk om mijn foto’s van mijn mobiel te back-uppen en om makkelijk bij een aantal bestanden te komen die je dan net even op je mobiel nodig hebt. Zo ben ik lang geleden begonnen met een gratis account bij Dropbox. En als je een vriend, familie of kennis aanbracht kreeg je gratis 500mb erbij. Zo kon ik een leuk 4GB cloud opslag accountje samenstellen. Daarna heb ik het account kunnen verhogen naar enkele tientallen GB’s omdat je dat gratis bij aanschaf van een mobiel kreeg. Maar op een dag besloot Dropbox dat ik weer terug moest naar het standaard plan van 2GB, Weg referrers, Weg deals met telefoonfabrikanten…

Toen overgestapt naar Google Foto’s. Dat was helemaal gratis en werd gewoon netjes in je Google drive opgeslagen! Dus de hele mikmak overgezet. Google deed het net wat beter, want foto’s worden heel mooi online getoond in een aparte subsectie van drive. Helemaal fan was ik van het terugkijken van 1 of meerdere jaren. Gaf je een leuk beeld wat je een jaar, 2 jaar of langer geleden bezig hield op dezelfde dag. Hun functie om op GEO locatie te zoeken was ook heel handig. Maar aan het gratis kwam een eind. Google kondigde aan dat full resolution niet langer gratis zou zijn, maar de gecomprimeerde versie zou nog wel gratis zijn. Nouja het is niet dat ik raw foto’s maak op mijn mobiel, en hun compressie was totaal niet zichtbaar. Dusja lekker verder met compressie aan. Totdat het volgende bericht kwam dat die ook niet meer gratis zouden zijn. Vanaf dat moment ging opeens de foto’s van mijn 15GB opslag af. En binnen 2 jaar was ik door die opslag heen.

Ik stond op het punt om bijna een Google Drive abonnement aan te schaffen, maar toen dacht ik, dat moet ik (met een hosting bedrijf) beter kunnen. Zijn er geen alternatieve die je zelf kan draaien? Ik had al lange tijd Nextcloud draaien, maar dat werkte niet lekker met foto’s backuppen (simpelweg omdat die helft vergat om mijn fotos te backuppen, files delen werkt dan weer wel prima). Met wat zoeken kwam ik op Immich uit. Toen weliswaar nog in BETA maar zag er zeer belovend uit.

Ik pakte een Raspberry PI, installeerde daarop Raspbian met docker en voordat ik het wist was de Immich container gedeployed! Ook de Android app stond zo op mijn telefoon. En in no time had ik mijn nieuwe ‘Google fotos’ online! Nu had ik maar een 16GB SD kaart in de raspberry zitten, dat gaf niet bepaald meer opslag dan Google. Dus kocht ik de PI hat die een SSD ondersteund samen met een 1TB small factor SSD. Nu kan je eenvoudig in de PI de SSD toevoegen, maar ik wou van de SD kaart graag af. Een SD kaart is namelijk niet bepaald de snelste als je daar een OS op hebt draaien. Bovendien is de levensduur van een SD kaart beperkt door het aantal schrijfacties van een OS. Dus kopieerde ik alle data naar de SSD, moest ik even de firmware van de PI updaten om van de SSD te kunnen booten en voilla! 1TB effectieve cloud opslag!

Mijn volgend probleem was dat de installatie thuis stond achter mijn router. Dat werkt prima als ik met mijn telefoon op wifi zit, maar zodra ik buiten de deur ben kom je er niet bij. Op dat moment had ik nog geen VPN ingericht dus koos ik ervoor om met Nginx een reverse proxy ervoor te zetten die enkel op poort 443 luistert. Daarmee is dus een SSL verbinding verplicht. Deze heb ik via Lets-encrypt geïnstalleerd en vervolgens het 443 poortje naar internet open gezet. En zo heb ik de perfecte Cloud opslag! Kosten?

UnitPrijs
Raspberry PI 5 – 4gb85
1TB SSD NVME60 (nu 130)
Pi SSD HAT15
USB-C Voeding15
Totaal175

Als je er vanuit gaat dat de set 5 jaar mee gaat dan kom, dan kom je op een maandelijks kostenplaatje van 2.91 euro. Met het stroomverbruik van 5 watt van de pi komt er met 25 cent /kWh een maandelijkse prijs van 0.90 bij. Ofwel voor een prijs van 3.81 heb ik nu 1TB cloud opslag!

Google foto’s heeft een pakket van 100GB voor 2 euro per maand, en dat is op zich ook niet gek als je aan 100GB voldoende hebt. Maar wil je vooral niet meer je foto’s met Google wil delen, of meer opslag nodig hebben en goedkoper willen hosten, dan kan ik de self hosted Immich variant zeker aanraden! En als je zelf graag ervaring wil opdoen met Linux, Pi en hosting dan zeker!

Self hosted: Jellyfin

In 2018 ben ik begonnen voor het eerst met een online streamingdienst abonnement. In dit geval met Netflix. Ik ben al lange tijd fan van streaming diensten, zo heb ik Spotify sinds het begin in 2011. En nu ook fijn om eindelijk je films en series te streamen. Een paar jaar later had ik daar ook Amazon Prime Video, HBO, NPO en Disney+ bij aangenomen. Dat was direct ook het moment dat er iets vreemds gebeurde. Voor het eerst zag je grootschalig content bij Netflix verdwijnen. Maar geen nood het kwam vaak op een andere dienst weer terug. En als je weer wat langer wacht kon het best zijn dat Netflix de aanbesteding van een bepaalde serie weer had gewonnen en het weer terug kwam op Netflix. Onhandig maar nog wel mee te werken.
Totdat de prijsverhogingen kwamen. Waar ik voor 2020 bij de meeste partijen een bedrag van 4-10 euro per maand betaalde is dat in 2026 bij merendeel verdubbeld. Ook begonnen de partijen het lenen van accounts aan te pakken. Waar Netflix in het begin dit bewust toeliet en het zelfs gebruikte in hun marketingcampagne! Waardoor voor veel mensen het best duur werd voor alle verschillende diensten maar iedere keer de hoofdprijs te moeten betalen. Laten we het dan ook niet hebben over de reclames die je tegenwoordig krijgt in je betaalde accounts.

En zo ben ik in Jellyfin gerold. Jellyfin maakt het mogelijk om je eigen streaming dienst te beginnen, helemaal zelf gehost op je eigen omgeving zonder invloed van derden. Een ideale manier om nog wat met je oude DVD iets te kunnen doen!

Met de komst van Jellyfin is mijn content weer stabiel (het is niet zomaar verdwenen), houd ik de prijs laag (eenmalige aanschaf), en bepaal ik ook welke versie film ik zie (Disney+ besluit namelijk zomaar bij Home alone 2 Donald Trump eruit te knippen, en oudere versies van Star Wars zijn ook niet te bekijken). Daarnaast heb ik nu zelfs content die op geen enkele streaming dienst staat. Denk aan bijv Thunderbirds, of mijn favo serie Chuck!

Wat heb je nodig om te beginnen?
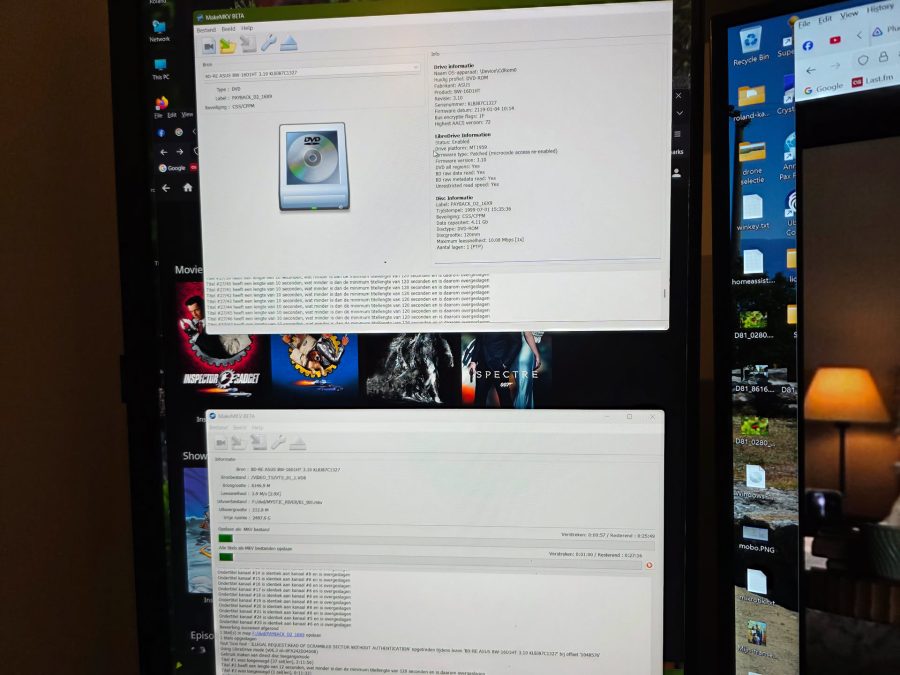
Een boel tijd en geduld. Ik ben eerst begonnen mijn eigen DVD collectie in te scannen, en dat kost ongeveer 10-15 minuten per DVD. Met het programma MakeMKV kan je de inhoud van een DVD omzetten naar een .mkv bestand op de computer. Ook mijn enige 2 Blu-ray discs heb ik ingescand: Golden Eye en The Dictator! Nou dat was nog een avontuur. Ergens in een oude computer had ik ooit een blu ray speler ingebouwd. Dus die eruit getrokken en in mijn huidige pc gestopt. Dan kom je erachter dat blu-ray met licenties werkt en ik dus eerst opzoek moest gaan voor de licenties van de films die ik heb. Gelukkig staat er veel op internet, en zodoende kon ik met de licentie ook middels MakeMKV de scan maken. Die overigens 30 min per disc duurt, en voilla!


Mooi dacht ik, nu wordt het tijd om mijn lievelingsfilm: Star Wars toe te voegen. De DVD versie had ik al ingescand en de blu-ray 4k versie had ik snel bij bol.com gekocht. Was erg goedkoop (12 euro per film) want er ontbrak Nederlandse ondertitels. Nouja geen probleem. Maar dat was wel een probleem voor mijn Blu-ray speler, want blijkbaar kon die geen 4k content aan. En probeer anno 2026 maar eens een blu-ray speler voor de computer te kopen! En omdat ik dat certifcaten gebeuren ook wel een beetje zat was heb ik een tweede hands model gekocht bewust met een oude firmware. Deze firmware kan je vervangen door je eigen versie waarmee je wat ‘flexibeler’ met die certificaten over weg kan. En zo kwam de 4k films ook binnen. (Dus doe je onderzoek hierin als je van plan bent blu-rays in te scannen).
Met het programma MKVToolNix kon ik de subtitles uit de DVD release halen en in de MKV van de 4k blu-ray toevoegen.

Transcoden
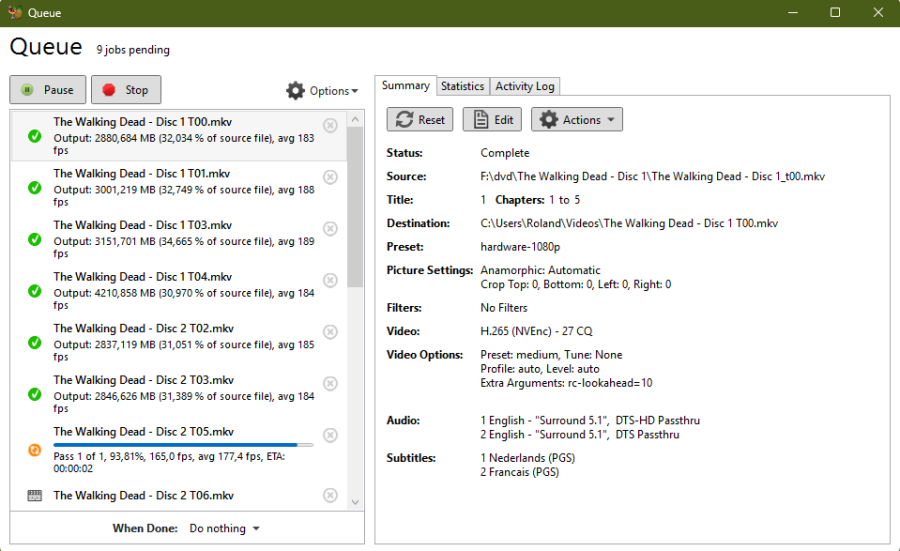
Een ander handig programma is Handbrake. Daarmee kan je de videobestanden transcoderen en daarmee comprimeren. Bijv een DVD heeft mpeg4 encoding, dat kan een hul stuk beter om naar h.264 of h.265 te zetten, bespaard zo 70% aan capaciteit zonder kwaliteitsverlies! Ook Blu-rays kan je omzetten, zonder daar een concessie in te doen kan je daar 50% besparen. Ik heb veel omgezet naar h.265 omdat dat tegenwoordig overal ondersteund wordt en net betere manier van compressie heeft zonder kwaliteitsverlies dan h.264. En naarmate ik bezig was kan ik AV1 ook aanraden. Handbrake heeft de optie je videokaart transcoder te gebruiken waardoor de snelheid drastisch omhoog gaat ten opzichte van cpu transcoding.

Echter is transcoding niet nodig, Jellyfin heeft FFMpeg ingebouwd en kan on the fly films transcoderen als de client het ene formaat niet aan kan. Het voordeel om alles van te voren wel te transcoderen is voornamelijk opslag besparing en ontzorgen van transcoden van Jellyfin. Bijv een h.264 wordt overal wel ondersteund. En dan hoeft Jellyfin niet on the fly meer transcoden als de bron al is omgezet.
Ik draai Jellyfin op een Intel N355 met ingebouwde GPU. Die gpu kan net 3 x een 4k stream aan als het gaat om on the fly transcoden. Eerder gebruikte ik een N100, en die kon 0.97x een 4k stream aan. Ofwel hier moest ik 5 min de film pauzeren want in realtime redde hij het net niet. En AV1 gaf mij problemen met sommige players die zeiden dat ze 4k av1 aankonden, maar bij afspelen gingen die haperen. Gelukkig kan je dan Jellyfin naar een ander formaat transcoderen zodat je alsnog kan kijken.

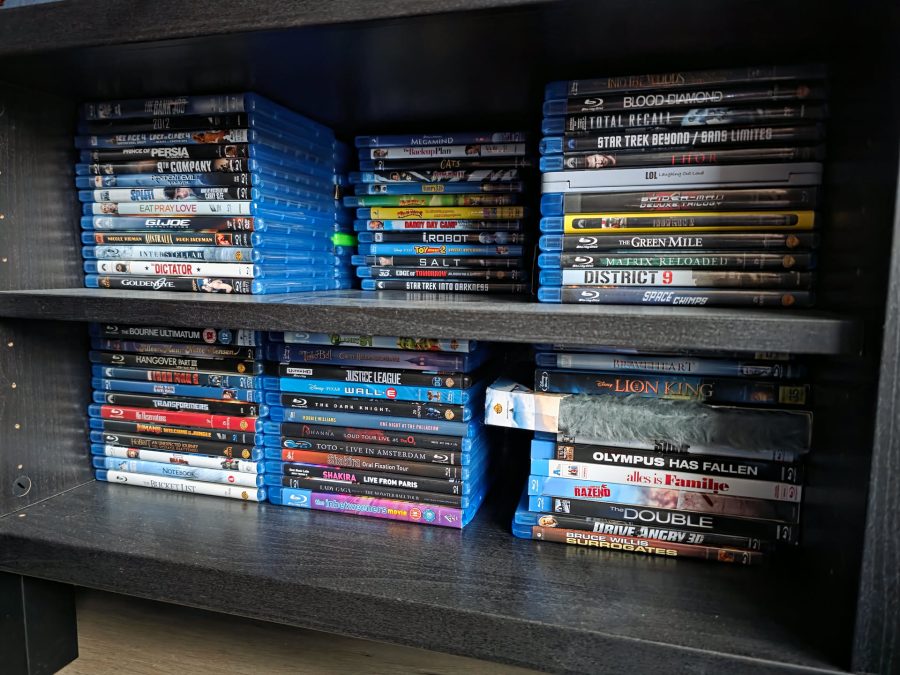
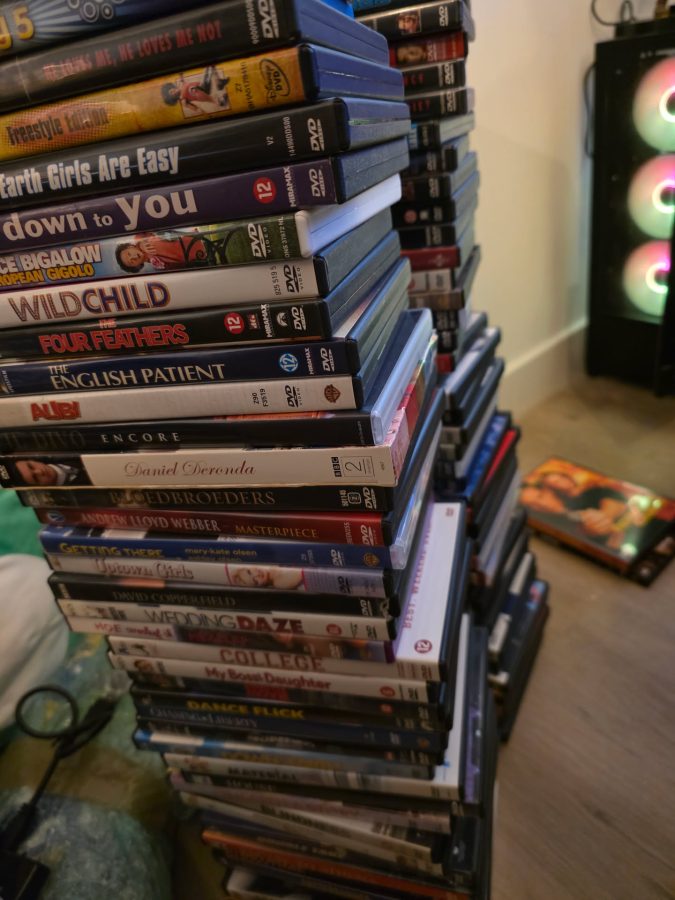
En als je eenmaal door hebt hoe het gaat kan je dus alles gaan toevoegen. Nadat ik mijn eigen DVD’s had gedaan ben ik regelmatig langs de kringloop gegaan, rommelmakten bezocht en heel af en toe op marktplaatst opzoek gegaan naar DVD’s en Blu-Rays. Om de kosten van de hobby niet uit de hand te laten lopen had ik een limit van 1 euro voor een dvd en 3 euro voor een blu-ray voor mezelf ingesteld. Op die manier heb ik heel veel films kunnen verzamelen: 465 Dvd’s en 283 Blu-rays.

Jellyfin
Jellyfin is een stukje software die je zelf kan hosten waarmee je je eigen streaming dienst op zet. Het heeft een ingebouwde webserver en serveert een webpagina aan media bestanden. Deze kan je dan heel eenvoudig in je browser streamen of je kan natuurlijk de bijbehorende apps installeren.

Installeren van jellyfin is erg eenvoudig, volg de handleiding op hun site en voila! Ik heb een kale VM voor jellyfin aangemaakt zodat alles in een eigen omgeving draait. Middels een NFS share bied ik Jellyfin de DVD en Blu-rays aan. Ik vond het een enge gedachte dat Jellyfin direct access moest hebben tot mijn share, vandaar de read only rechten op de movie map.
De VM is een proxmox VM. Dus met een beetje moeite kon ik de GPU in pass trough mode zetten naar deze VM, zodat Jellyfin de GPU on the fly kan gebruiken voor transcoding. Doordat het de interne gpu van de cpu is, trekt deze maximaal een 6 Watt stroom op moment dat volledige transcoding nodig is.
Vervolgens Jellyfin je media map laten scannen en voilla!

Hier en daar zal jellyfin mogelijk niet alles kunnen vinden. Soms komt dat door een typefout in de naam van het bestand of doordat er meerdere films zijn met dezelfde naam. Gelukkig kan je dat snel verhelpen of handmatig de meta data aan te passen.

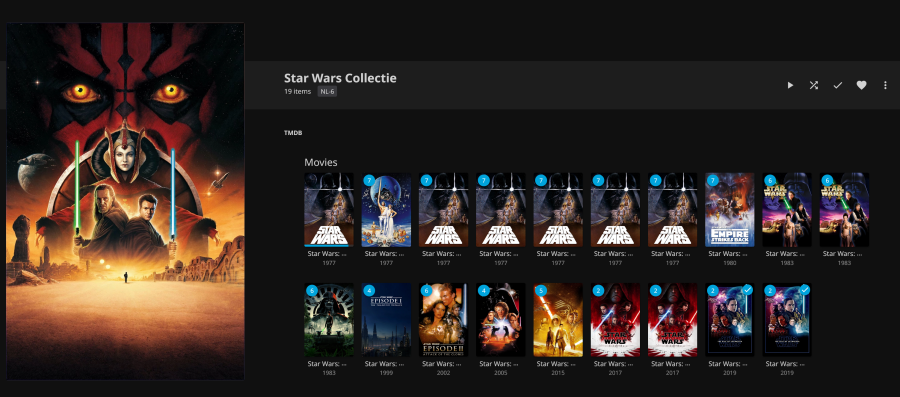
En als je de handleiding van Jellyfin volgt hoe de media map eruit ziet krijg je ook nog eens heel mooi de keuze welke versie film je wilt zien. Zoals in bovenstaande screenshot te zien valt kan je kiezen voor de 4k versie, de Blu-ray versie of de DVD versie.

Ik heb de server thuis draaien, en middels een VPN koppeling kan ik overal in de wereld mijn media streamen!
Je kan Jellyfin ook direct op het grote internet zetten, maar dan is mijn advies wel een SSL certificaat te gebruiken en de niet SSL versie uit te zetten.

Military 2025

En weer zijn we een jaar verder! Grappig dat mijn laatste post over de military van vorig jaar ging. Ach, zo ben je druk met van alles en dan zijn er minder posts.

Dit jaar was de partij die mij altijd uitnodigt verplaatst naar een nieuwe locatie. In plaatst van aan de binnenring hadden ze een stand bij de finish. Dat gaf ook een leuk beeld omdat je op deze plek meer in de race werd betrokken.

Military 2024

Voor het eerst mocht ik 3 dagen van de Military 2024 bijwonen. De opening op donderdagavond, een besloten partner event op vrijdagochtend met rondleiding door de stallen en zaterdag de cross country waarbij ik natuurlijk weer een aantal foto’s heb gemaakt.

Hengelo Lichtparade

In het verleden heb ik diverse keren carnaval in Haaksbergen lopen fotograferen. In Enschede hebben ze geen optocht, dus dan ook geen foto’s :P. En nu ik in Hengelo woon werd het tijd om de Carnaval op zijn Hengeloos mee te maken middels de Lichtparade!

Military 2023

Ook dit jaar was ik weer dankzij een leverancier aanwezig bij de Military 2023. Opvallend dit jaar was het parcours aangepast en daarbij zijn een paar rustige segmenten weggevallen. Deze segmenten waren altijd ideal om te kijken omdat niet veel mensen de moeite namen om hier heen te lopen. Ook de looppaden waren anders waardoor je soms op sommige punten erg lang deed om voorruit te komen.

Leuk was natuurlijk om weer een aantal foto’s te maken. En na de cross een heerlijk bok biertje met de leverancier drinken!

Melkweg fotograferen

In Enschede heb ik al meerdere pogingen gedaan maar in de stad is er te veel licht vervuiling. Dat geeft een gele gloed over je hele foto heen waardoor je de sterren niet goed kan zien. Speciaal voor deze sessie ben ik naar een stuk bos gereden bij Ugchelen waar niks anders is dan bomen en natuur en de bewoonde wereld een stuk verwijderd is. Tevens is dit ook het moment om mijn nieuwe 14-24mm F2.8 lens te introduceren. Deze heb ik een paar weken geleden gekocht speciaal zodat ik de melkweg goed kan vastleggen. Hoe lager je diafragma hoe meer je licht je kan vangen. Sommige zullen zeggen; dan zet je je camera op de statief. En dat is waar behalve dat de sterren zelf, of nouja beter gezegd de aarde ook blijft bewegen. Idealiter maak je je foto binnen 30 seconde omdat je anders bewogen sterren krijgt. Dat is een heel raar besef.
De grote hoek van 14mm is ook geen overbodige luxe om alles netjes op beeld te krijgen. De plek waar ik stond was zo donker dat ik niks zag en met een zaklantaren mezelf moest navigeren om een plekje te vinden. Foto 3 laat heel mooi zien waar ik stond, echter was het zo donker dat ik zelf ook de foto moest bekijken waar ik nu was. Samengevat:

  • Een plek met geen lichtvervuiling of zo minimaal licht
  • Een lens die een hele lage diafragma heeft, bijvoorkeur 2.8 of lager
  • Een lens die zo wide mogelijk is, 14mm is een goede keze
  • Zet je camera op een sluitertijd van 20-30 seconde
  • Zet je camera op vaste iso van 2000-4000
  • Stel je lens scherp op een heel ver object. Ik stond in het pikke donker, maar gelukkig had mijn lens een glaasje waaronder je kon zien op welke afstand hij stond. Mij bleek wel dat de perfecte punt niet ? was maar vlak iets daarvoor.
  • Geduld! (en een stoel of krukje om te zitten)

Ook een goede tip is om de melkweg in de gaten te houden. Er zijn sommige dagen dat de melkweg beter te zien is dan andere dagen. Ook kan een volle maan roet in het eten gooien doordat deze te veel licht kan geven.
Na 1.5 uur schieten is dit het resultaat: